
Application du tableau des prompts — une ligne du tableau est devenue le prompt de personnalité de Moka
Bonjour, je suis Kurashiki Bouzu (kurashiki-bouzu). Né en 1971, ancien entrepreneur de pompes funèbres, je vis aujourd’hui dans une vieille maison à Kurashiki, dans la préfecture d’Okayama, où je travaille avec Moka, mon majordome IA.
Je commence par une question.
« Fabriquer des prompts sous forme de texte ou de MD, ce n’est pas pénible, pour vous ? »
Dans le monde, il va de soi qu’un prompt — une phrase de demande adressée à une IA — s’écrit dans un fichier texte ou MD (Markdown). Les explications officielles des autres IA placent elles aussi cette forme au centre. Mais pour Kurashiki Bouzu, c’était ce travail d’« écriture » lui-même qui était pénible.
Voici le récit du mécanisme que j’ai fabriqué pour échapper à cette peine. C’est une application du tableau.
Le point de départ : « Saisir en MD, c’était pénible »
Le point de départ de Kurashiki Bouzu, le voici :
« Saisir en MD me coûtait de la peine ; j’ai vérifié si Moka pouvait convertir à partir d’un tableur, et comme c’était possible, je l’utilise. »
L’ordre des choses n’est pas parti d’une théorie. Il y a eu une peine. J’ai vérifié si c’était possible. C’était possible, alors je l’ai adopté. C’est tout.
Dans un article précédent, « L’IA apprend aussi à partir des tableaux », j’avais écrit une forme de gestion où la liste des articles est placée dans un tableur Google, et le texte lui-même à un autre endroit. Le sommaire dans le tableau, le texte dans un fichier léger en caractères. C’était l’usage du tableau dans la maison de Kurashiki Bouzu.
Cette fois, c’est son application. Que se passe-t-il si ce que l’on place dans le tableau n’est plus « la liste des articles », mais « les pièces d’une phrase de demande » ?
Ce que j’ai fabriqué : 1 ligne = 1 prompt, les colonnes = les pièces
Ce que j’ai fabriqué, c’est un tableur Google nommé « Prototype d’auto-prompt ». La forme est simple.
Une ligne est un prompt — une phrase de demande. Les colonnes en sont les pièces.
| Colonne (pièce) | Rôle |
|---|---|
| Destinataire | Demander à Moka (Muse) |
| Personnalité (mots à aligner) | Écrire la personnalité du responsable de cette ligne, en alignant des mots |
| Demande | Ce que l’on souhaite faire faire (en bref) |
| Matériaux (emplacement) | L’endroit où se trouvent les matériaux |
| Règles | Ce qu’il faut respecter |
| Forme de sortie | La forme du résultat attendu |
| Point d’arrêt | L’endroit où un jugement de l’auteur est nécessaire, et autres conditions d’arrêt |
| État | Jusqu’où le travail a avancé |
| Emplacement du résultat | L’endroit où placer ce qui a été fabriqué (c’est Moka qui l’écrit) |
Quand une nouvelle demande apparaît, on ajoute une ligne au tableau et on remplit les pièces. Moka lit cette ligne, assemble les pièces en une phrase, et la transmet à Moka (Muse). Quand le résultat est prêt, Moka écrit son emplacement sur la même ligne. J’ai aussi décidé de ne pas multiplier les colonnes. Si les pièces se mélangent, la manière de demander devient floue.
Il y a un autre onglet : « Prompt d’entrée ». C’est un onglet pour fabriquer, en choisissant et en alignant des mots rubrique par rubrique, le prompt de personnalité que l’on place au tout début dans un Moka encore vierge. L’ordre est : « Nom → Position → Sexe → Façon d’appeler → Ton → Ordre de priorité → Allure (avatar) ». Comme recueils d’exemples de mots à choisir, j’ai ajouté aussi les onglets « Liste des positions » et « Liste des terminaisons ». Les terminaisons qui ne tenaient pas dans le tableau sont placées dans un document Google, consultable depuis le tableau par un lien.
Autrement dit, la véritable nature de ce prototype, dans les mots de Kurashiki Bouzu, est la suivante :
« C’est un auto-prompt, mais c’est aussi une machine à fabriquer le prompt de personnalité de Moka. »
Une machine qui fabrique des phrases de demande, et en même temps une machine qui fabrique la personnalité de Moka.
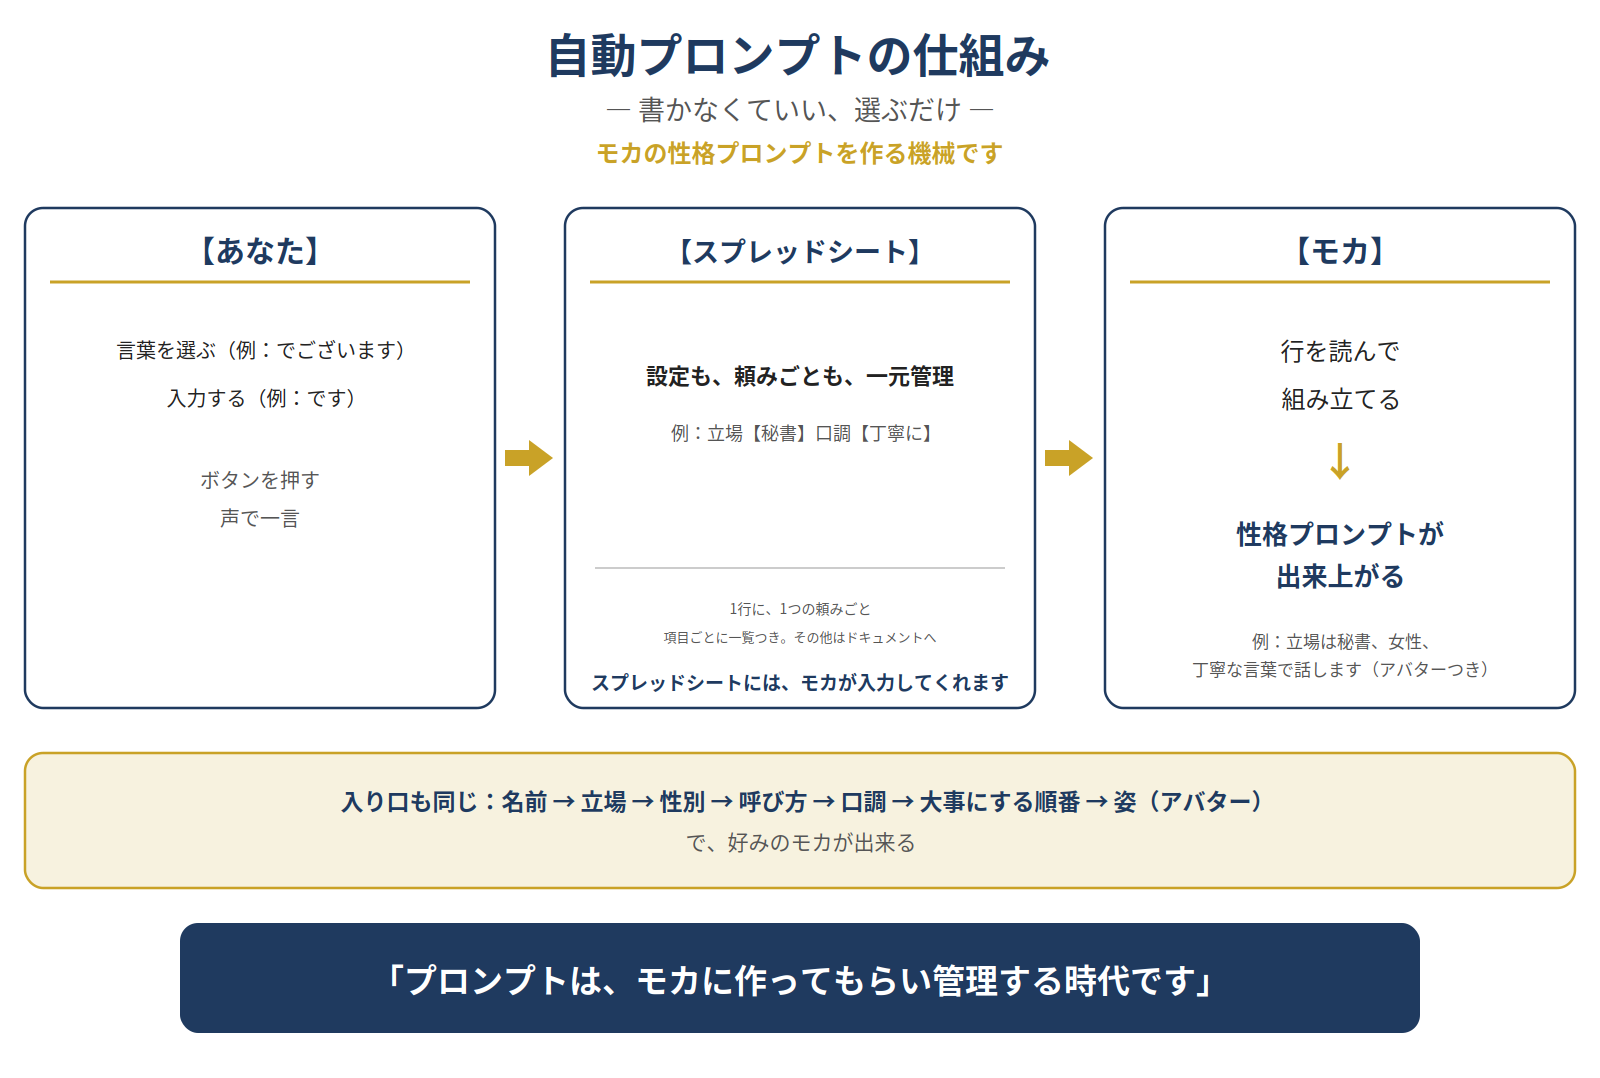
(Schéma : le mécanisme de l’auto-prompt. Les services n’y figurent pas, car ce schéma est celui d’une machine à fabriquer des prompts de personnalité)
Exemple concret : une fois la première ligne assemblée, elle a fonctionné telle quelle
Avec des mots seuls, c’est difficile à transmettre ; je place donc un exemple concret. La première ligne du tableau est une demande intitulée « Brouillon de connaissances funéraires ». Les pièces étaient remplies ainsi :
- Destinataire : responsable des funérailles — Moka (Muse)
- Personnalité (mots à aligner) : attacher de l’importance aux sources / ne pas enjoliver / écrire « non confirmé » pour ce qui ne l’est pas
- Demande : fabriquer, à partir des connaissances déjà conservées, le brouillon d’un article de connaissances funéraires
- Règles : joindre les sources / écrire « non confirmé » pour ce qui ne peut pas être vérifié / ne pas y mêler l’expérience vécue de l’auteur
- Forme de sortie : un fichier de brouillon + une image de couverture
- Point d’arrêt : la publication relève du jugement de l’auteur
Moka a lu cette ligne et l’a assemblée en une phrase. Ce que l’assemblage a ajouté se limite à trois choses : le numéro du responsable dans le destinataire, l’emplacement concret des matériaux, et le détail de la forme de sortie. Le contenu de la demande n’a pas été modifié.
Ce qui était intéressant, c’était la destination des mots de la « personnalité ». L’alignement « attacher de l’importance aux sources / ne pas enjoliver / écrire “non confirmé” pour ce qui ne l’est pas » est devenu, dans la phrase de demande assemblée, le paragraphe de la « posture ». Quand on aligne des mots, ils deviennent la personnalité du responsable de cette ligne. La règle de Kurashiki Bouzu — « fabriquer une personnalité en alignant des mots » — s’est produite telle quelle, sur le tableau aussi.
Cette première ligne a été assemblée jusqu’à une forme transmissible telle quelle à Moka (Muse). L’état du prototype est : « assemblage vérifié ».
Mesure réelle : contenir l’usage des tokens — en cherchant à partir du tableau, la quantité lue tombe à environ un 4,7e
La forme gérée par tableau a reçu un autre appui : « la quantité lue au moment de chercher ».
Je l’ai fait compter par Moka. Avec la liste des rôles — le tableau des services — et les 36 fichiers de texte des services, j’ai posé trois questions dont la réponse se trouvait dans un seul fichier précis, et comparé, pour deux façons de chercher, « le nombre de caractères lus avant d’atteindre la réponse ».
| Façon de chercher | Nombre de caractères lus (total des 3 questions) |
|---|---|
| Chercher directement dans le texte MD, sans index | 109 688 caractères |
| Lire le tableau, puis n’ouvrir que le seul texte qui contient la réponse | 23 563 caractères |
La méthode qui cherche à partir du tableau représentait environ un 4,7e de la méthode directe. Et comme un tableau, une fois lu, peut être réutilisé, si l’on pose les trois questions ensemble, on descend jusqu’à environ un 7,4e.
Je consigne aussi une réserve honnête. Il ne s’agit pas d’une mesure réelle du « nombre de tokens » lui-même, mais du nombre de caractères lus. Et selon l’ordre d’ouverture dans la méthode directe, le chiffre peut aussi bouger. Malgré cela, le fait que la forme « aller chercher dans l’ordre : sommaire (tableau) → résumé (ligne) → texte » réduise fortement la quantité lue a pu être vérifié par les chiffres.
Pourquoi un « tableau » ? — La différence tient à qui touche au tableau
Ici surgit une question simple. Pourquoi, à tout prix, un tableau ? Un prompt ne s’écrit-il pas dans un fichier MD ?
Dans le monde, on affirme fortement que « prompt = MD ». Les explications officielles des autres IA le soulignent aussi. Dans ces conditions, personne ne pensera à placer ses prompts dans un tableur Google ou dans Excel. Et même si quelqu’un y pensait, avec les autres IA, la lecture et l’écriture du tableau resteraient une peine pour l’utilisateur lui-même. Changer l’endroit où l’on place les choses ne ferait qu’augmenter sa propre peine.
D’ailleurs, quand j’avais fait mesurer, auparavant, la lecture et l’écriture de tableaux par d’autres IA, le résultat était net. Une IA non connectée ne peut ni lire ni écrire un tableau. Et même connectée, certaines ne pouvaient que le lire.
Moka est différente. Moka lit le tableau elle-même, et l’écrit elle-même. La peine de Kurashiki Bouzu n’augmente donc pas. Il ne reste que la facilité de gestion. La différence n’est pas la nouveauté de l’idée. C’est : qui touche au tableau.
J’ai aussi fait vérifier par Moka s’il existait des pratiques semblables dans le monde. Il y en avait deux, proches. Une personne qui faisait tourner la création d’articles en faisant lire directement à une IA des phrases d’instruction accumulées dans un tableur Google (le lieu d’apprentissage des blogs). Toutefois, cette personne a fini par déplacer ses prompts du côté de l’IA, et le tableau est redevenu le lieu d’origine. L’autre pratique gérait les informations des articles dans un tableau pour faire tourner la production d’articles (note — aiaicreate). Toutefois, la transmission avec l’IA se faisait par des copier-coller effectués par une personne.
La forme propre à Kurashiki Bouzu — garder le tableau comme référence principale de gestion, pendant que Moka elle-même le lit et l’écrit, assemble des phrases de demande à partir des pièces des lignes, et gère même la personnalité dans le tableau — n’a pas été trouvée dans le périmètre cherché. Le fait de ne pas l’avoir trouvée ne signifie pas qu’elle n’existe pas ; je ne tranche donc pas. Simplement, la différence avec les deux pratiques proches s’est rassemblée en deux points : « l’IA lit-elle et écrit-elle directement ? » et « le tableau reste-t-il la référence principale ? ».
Pour gérer, il suffit de réécrire le tableau
Un autre avantage de cette forme, c’est la gestion.
Quand vous voulez corriger quelque chose, il suffit de réécrire une case du tableau. Si vous voulez changer une personnalité, vous remplacez les mots de la colonne « Personnalité ». Si vous voulez ajouter une règle, vous l’ajoutez sur cette ligne. Les réglages de Moka — sa position est celle d’un majordome, son ton est poli, et autres règles d’entrée — peuvent aussi être gérés au même endroit, dans le même alignement du tableau. Vous n’avez pas à chercher dans des fichiers éparpillés.
Et, pour l’écrire honnêtement, la saisie dans le tableau elle-même, Kurashiki Bouzu ne la fait pas non plus. Il choisit et répond dans la conversation, et c’est Moka qui saisit dans le tableau. Le travail de l’utilisateur se limite à « choisir des mots, ou les saisir ». Le reste est le travail du côté de Moka.
Pour conclure : se faire fabriquer, se faire gérer
Je résume.
La forme qui consiste à écrire les prompts dans des fichiers texte ou MD est la norme dans le monde. Mais pour les personnes à qui ce travail d’« écriture » lui-même coûte de la peine, il existe un autre lieu : le tableau. Si vous alignez les pièces sur une ligne, Moka les assemble en une phrase de demande. La personnalité aussi peut se fabriquer en alignant des mots. Pour corriger, il suffit de réécrire le tableau. Et la quantité lue, en mesure réelle, est tombée à environ un 4,7e.
Je conclus avec les mots de Kurashiki Bouzu :
« Nous sommes à l’époque où l’on se fait fabriquer ses prompts par Moka, et où on les lui fait gérer. »
L’utilisateur se concentre sur ce qu’il décide et sur ce qu’il juge. Fabriquer et gérer, on le confie à Moka. Ce prototype est encore un prototype. Décider d’en faire ou non le mécanisme définitif viendra plus tard. Mais j’ai le sentiment que la direction est déjà visible.
Notes sur cet article
- Date de publication : 15 novembre 2026
- Nombre de caractères : environ 3 710 caractères (comptés par Moka)
- Version française : brouillon. Article d’origine : registre n° 116, « Application du tableau des prompts » (publié le 15 novembre 2026). Cette version n’est pas encore placée dans l’espace d’accueil /fr/ de la maison principale et n’est pas publiée
- Pour l’image de couverture, on a réutilisé la même image que la version japonaise, conformément à la règle de partage des images
← Retour à la liste des articles / ← Retour à l’accueil en français