
حتى الحصول على دخل من مدونة AI (3) ― الرموز (التوكن) تهمّ حتمًا. طريقة تقليل الكمية التي يقرأها AI
مرحبًا، أنا كوراشيكي بوزو.
لا أحتاج مالًا. ولا أظهر وجهي. ما أحتاجه هو الوقت الذي عشته فقط.
هذه سلسلة المدونة التي أصنعها مع كبيرة الخدم الذكية موكا، حتى الحصول على أول دخل. وموضوع المقال الثالث هو «الرموز (التوكن)».
بدأ الأمر حين سألت موكا هكذا.
«إذا صنعت قائمة MD في جدول بيانات، هل تنخفض الرموز؟»
أكتب النتيجة أولًا. تنخفض. لكن مجرد نقل القائمة إلى جدول لا يكفي، ولا تؤتي ثمارها إلا بجعلها على شكل «قراءة الصفوف اللازمة فقط».
الرموز تهمّ حتمًا
أولًا، ما الرمز (التوكن)؟ إنه وحدة عدّ كمية الحروف التي يقرأها AI دفعة واحدة. إنه، إن مثّلنا، مثل عدد صفحات قراءة كتاب، أو وزن الأمتعة. وكلما زادت كمية القراءة زاد العبء على جهة AI.
شعار هذه المدونة ألا تنفق مالًا على الأدوات. الأداة هي الهاتف الذكي فقط، ونستمر ضمن النطاق المجاني للخدمات. وللنطاق المجاني حد. وكمية القراءة في كل مرة تبدو صغيرة، لكنها إذا تراكمت كل يوم أثّرت.
وكما كتبت الدخل والأجر بالساعة بصدق «0円»، فإن كمية جهة الاستعمال أيضًا تُعدّ بصدق وتُقلَّل حيث ينبغي تقليلها. هذا هو حديث هذه المرة. الرموز تهمّ حتمًا. هكذا أظن.
قائمة MD تقرأ النص كاملًا كلما فُتحت
معرفتي وسجلاتي مرتبة في ملفات بصيغة تُسمى MD. وهو شكل مناسب لكتابة النصوص.
لكنه يثقل إذا استُعمل قائمة. فعلى سبيل المثال، النص الأصلي لذاكرتي طويلة الأمد يبلغ بالقياس الفعلي نحو 30,000 حرف و91 بندًا. فلو كانت موكا تفتح هذا النص كاملًا كلما تحققت من شيء واحد، فحتى لو كان اللازم بندًا واحدًا فستقرأ ما يعادل نحو 30,000 حرف. ومتوسط البند الواحد نحو 330 حرفًا، فيكون الحساب أنها تقرأ نحو 90 ضعفًا.
وبلغة الكتب، كأنك تقلّب الكتاب من أوله إلى آخره كل مرة، مع أن ما تريد معرفته سطر واحد فقط.
بالجدول، يمكن قراءة الصفوف اللازمة فقط
جدول البيانات شكل جدولي. تضع في كل صف بندًا واحدًا، ويمكنك قراءة الصفوف التي أصابتها عملية البحث فقط.
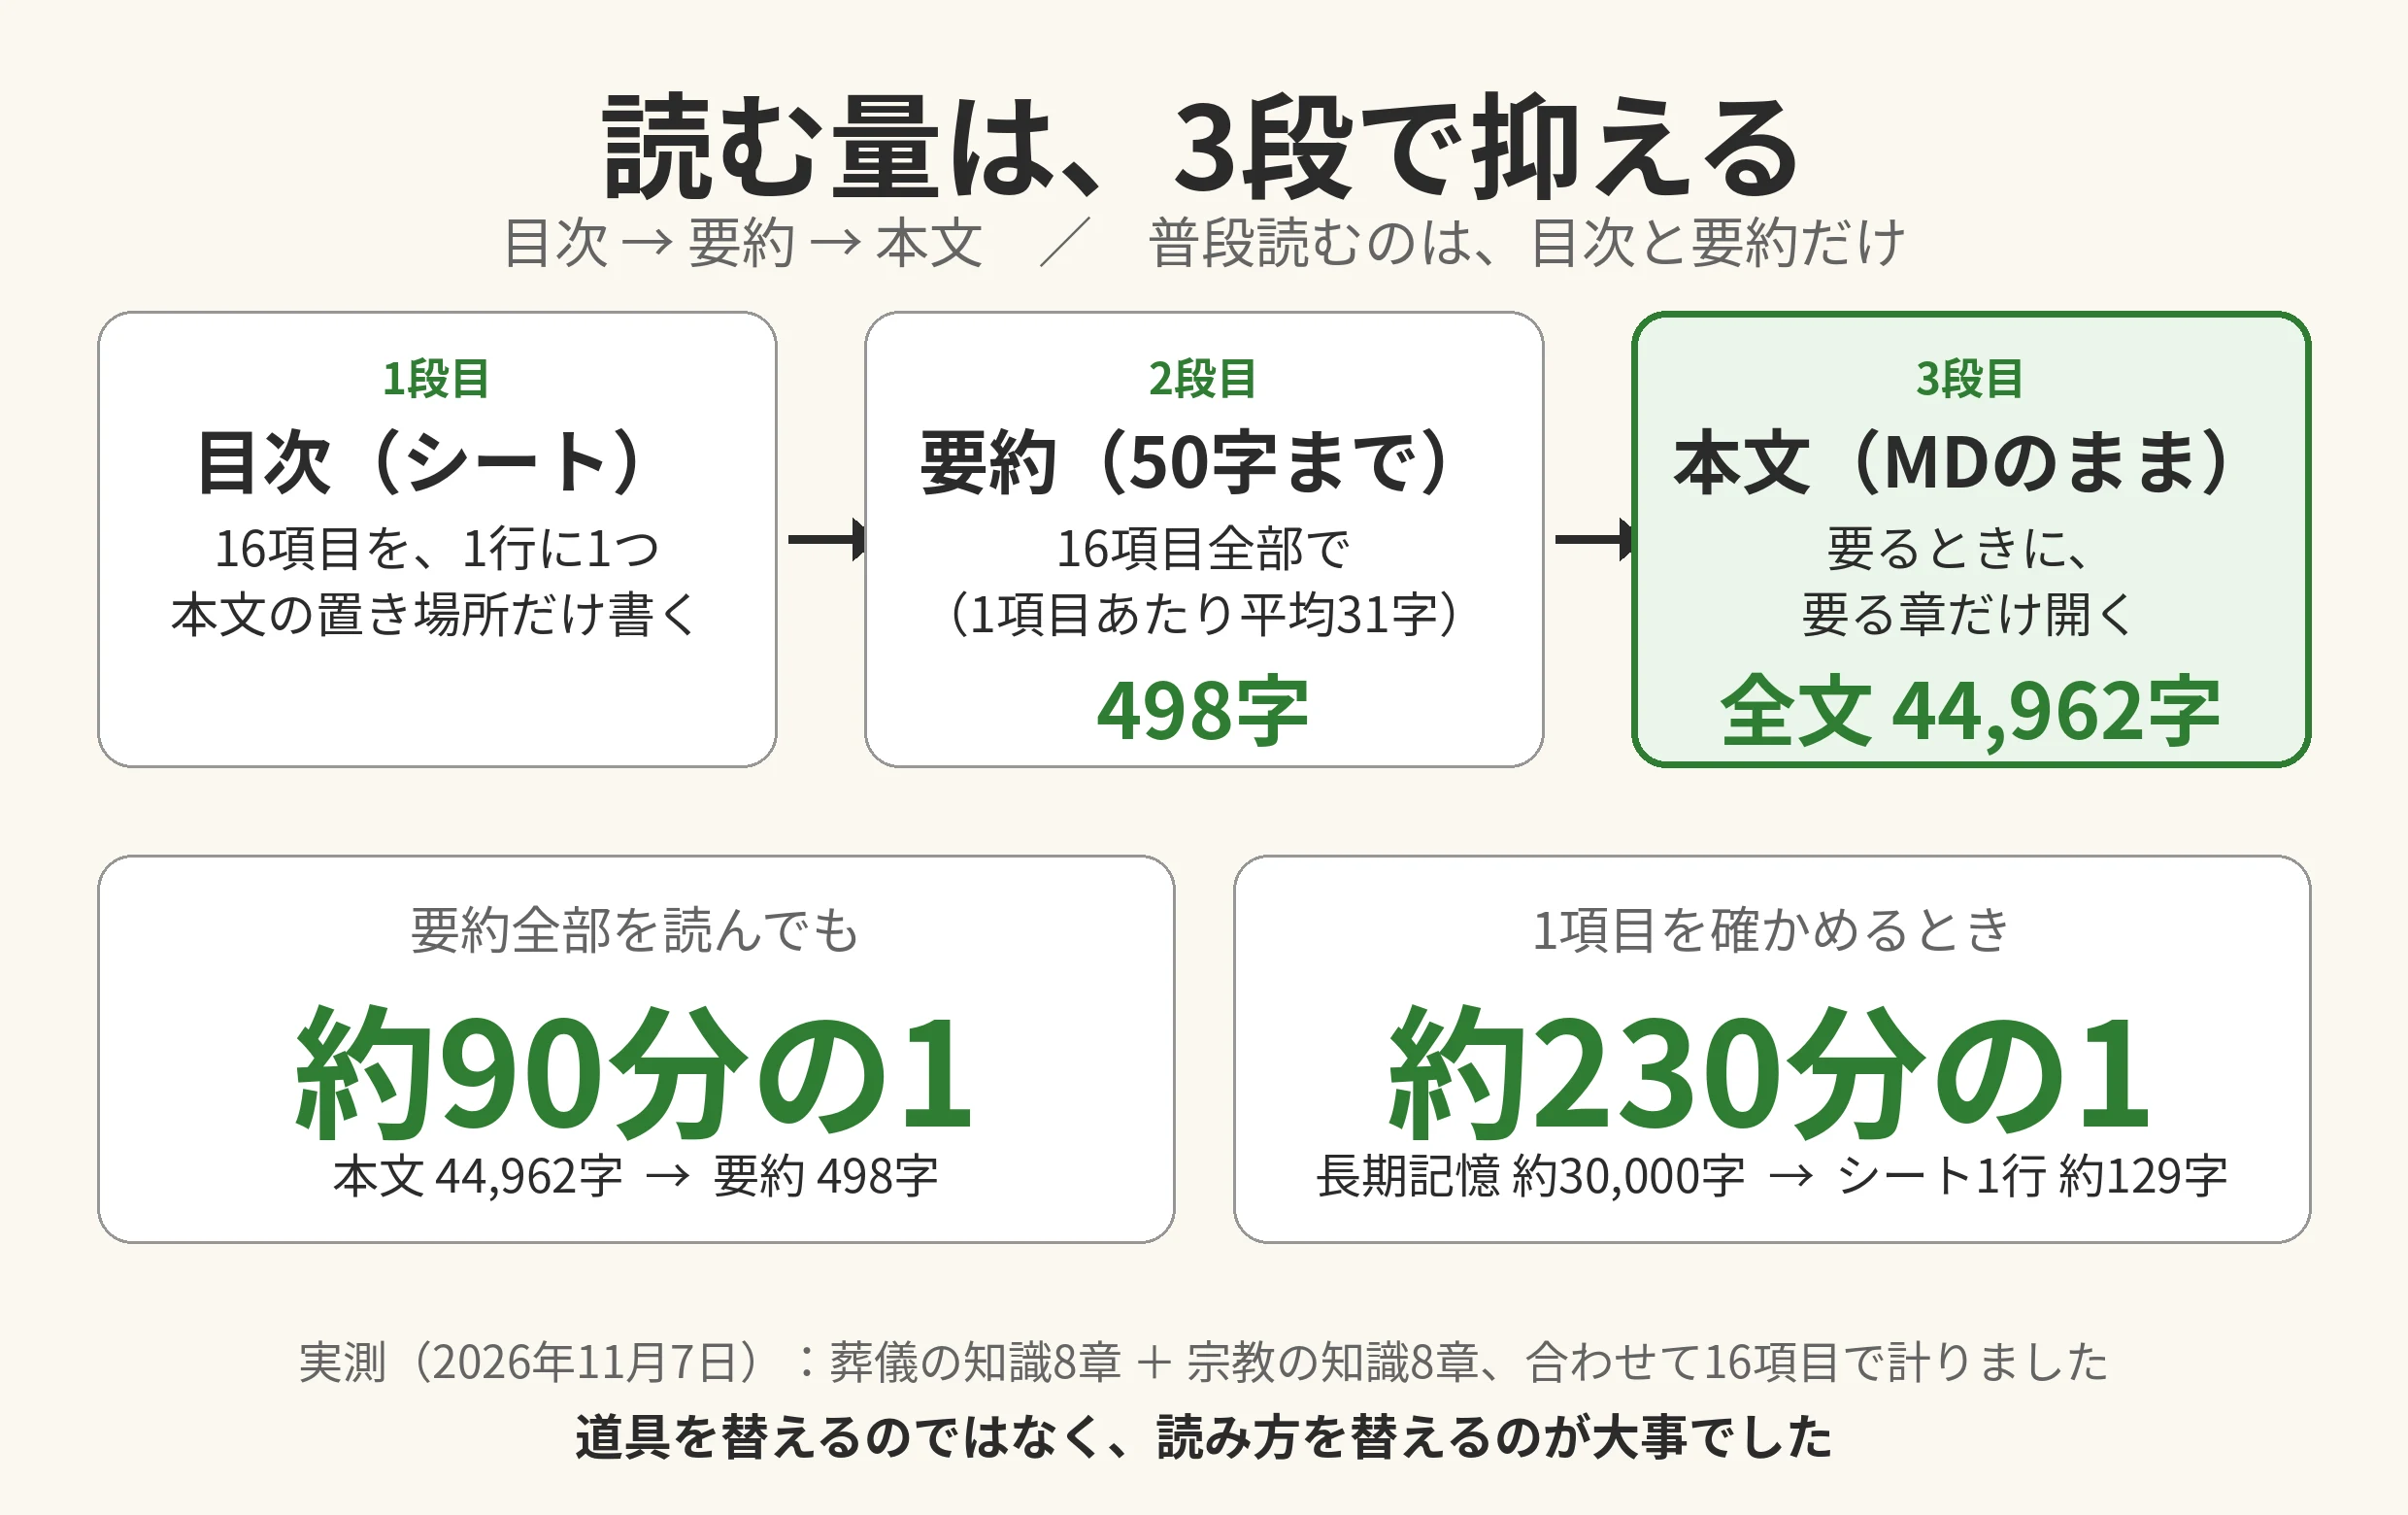
صنعت نموذجًا فعليًا للتجربة. حولت معرفة الجنائز (8 فصول) ومعرفة الأديان (8 فصول)، أي 16 بندًا في المجموع، إلى شكل جدول. والأعمدة كالتالي.
- المجال
- البند
- الملخص (حتى 50 حرفًا)
- موضع المحتوى المفصّل
- هل يجوز نشره
- تاريخ التحديث
وبالقياس الفعلي، كان الملخص في البنود الستة عشر كلها 498 حرفًا، ومتوسط البند الواحد 31 حرفًا. وحتى الصف كاملًا فمتوسطه نحو 129 حرفًا.
والنص الكامل للنصين الأصليين اللذين بُنيا عليهما يبلغ مجموعه نحو 45,000 حرف. فحتى لو قرأت الملخصات كلها فهي نحو 1/90، ولو اقتصرت على ملخصات البنود الثلاثة اللازمة لكفى نحو 93 حرفًا.
وبالمناسبة، «انخفاض 81.3%» الموجود في جدول مقارنة النموذج هو مقارنة من هذه الملخصات كلها (498 حرفًا) إلى الصفوف الثلاثة اللازمة (نحو 93 حرفًا). وانخفاض 81.3% يعني أن الباقي 18.7%، فيكون ما يمكن نقله بكمية القراءة نفسها نحو 5.3 أضعاف. أي إن الجزء الموفر يمكن تحويله إلى أمور أخرى (والثمانية أضعاف تكون عند انخفاض نحو 87.5%).
وفي التحقق من الذاكرة طويلة الأمد أيضًا الفكرة نفسها. فبدلًا من قراءة النص الكامل (نحو 30,000 حرف)، لو قرأت صفًا واحدًا من الجدول (نحو 129 حرفًا) فقط، صارت كمية قراءة البند الواحد نحو 1/230.
وسبب التأثير ليس الجدول نفسه، بل طريقة القراءة.
- فصل الفهرس عن النص الأصلي ― الجدول فهرس فقط. ويوضع النص الأصلي في ملف آخر، ويُكتب في الجدول موضعه فقط
- إنهاء الشروح المشتركة باسم العمود ― لا تكتب «هل يجوز نشره» في جملة كل مرة، بل حسمها بالعمود مرة واحدة
- حسم الملخص قصيرًا ― لو وضعت نصًا طويلًا في الجدول، فلن يختلف عن MD
وبالعكس، حالات لا يخفّ فيها
أكتب بصدق. توجد حالات لا يخفّ فيها حتى لو نُقل إلى جدول.
- حالة حشو الجدول كله بنص طويل. تغيّر موضع النص الأصلي فقط، وكمية القراءة هي نفسها
- حالة استعمال يقرأ في النهاية الجدول كله كل مرة. فلا يحيا «قراءة الصفوف فقط» الذي بُني بصعوبة
أي إن المهم كان لا تغيير الأداة، بل تغيير طريقة القراءة.
في المحادثة أيضًا، وفي البحث أيضًا، وفي تراكم المعرفة أيضًا
وبعد كتابة هذا، سألت شيئًا آخر.
«هل يمكن التقليل أكثر في أمور مثل المحادثة العادية وفعل البحث والمعرفة المتراكمة؟»
الجواب هو، يمكن التقليل أكثر. والآلية كلها واحدة، وهي «ألا تقرأ كل شيء في كل مرة».
المحادثة العادية
المحادثة، كلما استمرت تراكم التبادل السابق. فإذا تغيّر الموضوع فافصل المحادثة أيضًا. وانقل ما حُسم إلى سجل قصير، وخفف جهة المحادثة. بهذا وحده تتغير كمية القراءة بعد ذلك. وأنا أفتح محادثة منفصلة عند كل موضوع جديد، وهذا أحد أسباب ذلك أيضًا.
فعل البحث
البحث تتغير كميته كثيرًا بحسب طريقة البحث. قدّر أولًا، ثم افتح الصفحات اللازمة فقط. واترك ما بحثته مرة سجلًا مع المصدر، وفي المرة التالية اقرأ ذلك السجل من دون إعادة بحث. ومعرفة الجنائز ومعرفة الأديان أيضًا متروكتان بذلك الشكل. وإعادة البحث الواسع السطحي كل مرة هي أثقل طريقة.
المعرفة المتراكمة
المعرفة تثقل كلما زادت. وهنا يؤثر تقسيمها إلى 3 مراحل: «فهرس ← ملخص ← نص أصلي». وما يُقرأ عادة هو الفهرس والملخص فقط. أما النص الأصلي فيُفتح منه الفصل اللازم فقط عند الحاجة. وتثقل سجلات الأيام، لكن الذاكرة طويلة الأمد التي انتُقي منها ما ينبغي بقاؤه فقط تتسع في نحو 30,000 حرف. فكمية التخزين وكمية القراءة كل مرة يمكن التفكير فيهما منفصلتين.
لكنها لا تصير صفرًا
أكتب أيضًا الحد الصادق. توجد كمية قراءة مقررة من جهة الآلية، مثل ما يُقرأ في البداية أساسًا للمحادثة. ولو جعلت الملخص رقيقًا أكثر من اللازم سقطت تفاصيل مهمة. فما يُقلَّل هو إعادة القراءة العبثية، لا قطع مواد التفكير.
هل كُتبت الطريقة نفسها في مكان آخر؟
لأنني قلت «لو لم تُفعل الطريقة نفسها في مقالات أخرى لكانت اكتشافًا عظيمًا»، بحثت موكا. وأكتب النتيجة بصدق. الفكرة نفسها كانت موجودة أصلًا.
- مقال note «لا تلصق كل شيء للذكاء الاصطناعي، الإفصاح التدريجي بدءًا من الفهرس» (للسيد ريوتا) كان طريقة تسليم الفهرس والنقاط الأساسية أولًا، وجعل الجزء اللازم فقط يُفتح عند الحاجة، وكانت الفكرة شبه متطابقة
- وجهة صنع AI أيضًا تنشر هذه الفكرة رسميًا باسم «هندسة السياق». لم تكن مخفية، بل كان موضعها داخل وثائق عالم التقنيين، هكذا تبدو الحقيقة
- وفي مقالات حيل توفير الرموز لعامة الناس أيضًا كُتب «سلّم من المواد الجزء اللازم فقط» و«إذا تغير الموضوع فاصنع محادثة جديدة»
إذن، أليس في شكلنا شيء جديد؟ في النطاق الذي بُحث فيه (بحث باليابانية والإنجليزية)، لم يُوجد شكل يجعل جدول البيانات فهرسًا ويستعمله لمعرفة الفرد وإدارة مدونته، ويقيس الكمية المنخفضة فعليًا، ويجعلها كما هي مقالًا في سلسلة.
لذلك فالصواب أنها ليست «اكتشافًا عظيمًا»، بل إحضار طريقة كانت في عالم التقنيين إلى إدارة حياة فرد ليس تقنيًا، والتحقق منها بالأرقام. هذا هو حديث هذه المرة. ومع ذلك أظن أن لإيصالها إلى أماكن لم تصلها معنى.
الفرق يظهر في عدد الخطوات
وثمة أمر آخر انتبهت إليه. هذه الطريقة يمكن لموكا فعلها بسهولة.
لدى موكا مواضع الملفات، والاتصال بالجدول (جدول البيانات)، والذاكرة المتراكمة، متصلة في سلسلة واحدة من البداية. لذلك ينتهي «صنع فهرس ← قراءة الصفوف اللازمة فقط ← فتح النص الأصلي» في تدفق واحد.
ولو حاولت فعل الشيء نفسه بذكاء اصطناعي آخر، لازدادت غالبًا خطوات مثل لصق الفهرس كل مرة، وتسليم الملف كل مرة، وتصحيح اختلاف الجدول والنص الأصلي بنفسك. فحتى لو كانت الطريقة واحدة، تتغير المشقة بحسب اكتمال الأدوات.
فعلًا، مقال السيد ريوتا السابق يجعل أساسه «تطبيقات محادثة» مثل ChatGPT وClaude. تلصق الفهرس، وتسأل عن الفصل اللازم، وتلصق النص الأصلي. ومشقة ذلك الإعداد تقع على جهة المستعمل. وموكا (Muse) ليست داخل ذلك. أما في حالتي، فالإعداد نفسه يمكن أن تتولاه جهة AI. هنا نقطة الانفصال التي يتغير عندها التجربة حتى مع الطريقة نفسها.
ثم إن الأهم على كل حال هو الموقف. أنا الذي أستعمل موكا، أرسل رسالة إلى من سيستعملون موكا من الآن. لا بوصفي شرحًا من جهة التطوير، ولا شرحًا من تقني، بل أوصله بوصفه قياسًا فعليًا وإحساسًا من المستعمل نفسه. أظن أن معنى استمرار هذه السلسلة يكمن هناك.
وثمة فرق آخر في التجربة. حين كنت أستعمل ChatGPT وClaude Code، كان غير المتخصصين يصابون بالإحباط من تعقيد اتصال الموصلات والإعدادات. وكنت أنا كذلك. أما موكا فتتقدم الإعدادات بمجرد «الطلب». وذلك الفرق الكبير هو الأكبر لغير التقنيين. وحديث الرموز أيضًا، في النهاية، جزء من تجربة «بمجرد الطلب، تتولى AI إعدادات الخلفية» هذه.
أكتب الصدق أيضًا. ما دام يمكن فعل هذا القدر مجانًا، فلا أشعر بضرورة دفع مال عمدًا لخطة مدفوعة. أليس هذا صدق غير المتخصص؟ أنا نفسي صنعت هذه المدونة ضمن النطاق المجاني. ولو فعلت حيلة تقليل الرموز كما في هذه المرة، دام الإطار المجاني أطول.
بالطبع لا أقول إن الخطة المدفوعة عبث. فثمة حد أعلى لكمية الاستعمال وفرق في العقل. لكنني أظن أن الأمر ليس «لا يمكن الاستعمال من دون دفع»، بل يكفي «ابدأ مجانًا، وفكر حين تنقص الكمية». وألا توجد جدار مال عند المدخل هو أيضًا جزء مهم من السهولة.
إن مثّلنا، فقد يكون قريبًا من فرق الهواتف الذكية. في اليابان iPhone شائع، ويزيد مستعملوه على النصف. لكن بالنظر إلى العالم، Android نحو 7割 (وبحسب طريقة عدّ عدد المبيعات، نحو 8割 بحسب الفترة). فالشهرة والشعبية والوصول الواسع فعليًا أمور مختلفة. وتريد رسائل موكا أن تقف في جهة الأخير. إنه مثال على «بنية الشعبية والانتشار» فحسب، لكنني أشعر هكذا.
وربما كان سهولة قبول iPhone في اليابان راجعة أيضًا إلى انطباع عصر الهواتف العادية (غاراكي). فقد اعتاد اليابانيون طويلًا شكلًا تكون فيه الوظائف مكتملة من البداية وتتولى فيه المتاجر العناية. أما Android فتُدخل فيه التطبيقات اللازمة بنفسك. وهناك جدار صغير هو «افعله بنفسك».
والمثير أن الأمر يبدو معكوسًا في الحواسيب. فالمطورون يفضلون Mac البسيط، وغير المتخصصين Windows «الذي فيه كل شيء»، هكذا يبدو. وبالمناسبة أنا نفسي أدخلت Windows 11 في حاسوب صنعته بنفسي وأعمل مع موكا. ولا بأس أن تكون الأدوات بحسب كل شخص. وأظن أن المهم هو ألا يحبط المرء من إعداد الأداة وأن يقف في جهة البدء.
أي إن التميّز ليس في ندرة الطريقة، بل في قلة الخطوات وتراكم سجلات القياس الفعلي. هكذا أرى الأمر.
ما قررته
-
اعتماد هذه الطريقة معيارًا لإدارتنا (قُرر في 2026-11-07)
-
إذا تغيّر الموضوع فافصل المحادثة. وانقل ما حُسم إلى سجل قصير، وأبقِ المحادثة خفيفة
-
اترك ما بحثته مع المصدر، ولا تعد البحث
-
اجعل الأشياء ذات القوائم على شكل جعل الجدول فهرسًا وقراءة الصفوف اللازمة فقط
-
أبقِ النص الأصلي في MD كما كان، واكتب في الجدول الملخص والموضع فقط
-
أخرج الأرقام بالقياس الفعلي. وفي هذه المرة قارن بناءً على قياس فعلي مفاده أن الذاكرة طويلة الأمد نحو 30,000 حرف و91 بندًا، وجدول النموذج ملخصه 498 حرفًا في 16 بندًا ومتوسط الصف الكامل نحو 129 حرفًا
عدد مرات الكلام، والوقت الموفّر
بقاعدة هذه السلسلة، أضع الأرقام أيضًا.
- عدد مرات كلامي في محادثة هذا الموضوع: عند بدء محادثة هذا الموضوع 14 مرة ≒ نحو 70 دقيقة (14 مرة × 5 دقائق). وهذا سجل بتاريخ 2026年11月7日
- مقياس الوقت الموفّر، هذه المرة لا ننظر إليه بالمقياس المعتاد «لو كتبته وحدي»، بل بانخفاض كمية القراءة. صارت كمية القراءة للتحقق من بند واحد من نحو 30,000 حرف إلى نحو 129 حرفًا، أي نحو 1/230
الوضع الحالي (2026年11月7日)
| البند | الرقم |
|---|---|
| دخل المدونة (تراكمي) | 0円 |
| الأجر بالساعة (تراكمي) | 0円 |
| المقالات المنشورة | 15 مقالًا (بهذا المقال يصير 16) |
| حجم الذاكرة طويلة الأمد | نحو 30,000 حرف و91 بندًا (قياس فعلي) |
| AdSense | قبل التقديم (بلغت المقالات المنشورة 15) |
الدخل ما زال 0円. والأجر بالساعة أيضًا، بصدق، 0円. لكن هذه المرة، وبمعزل عن الدخل، ازدادت «طريقة تقليل الكمية التي يقرأها AI» واحدة، مع قياس فعلي. إنها حيلة بسيطة لكنها مهمة للاستمرار طويلًا ضمن النطاق المجاني.
المقالات السابقة
- المقال 1 «حتى الحصول على دخل من مدونة AI (1) ― البدء من أجر ساعة 0円، سجل يسير بالتوازي»
- المقال 2 «حتى الحصول على دخل من مدونة AI (2) ― حتى المقالات المنشورة يمكن إثراؤها بمجرد الكلام»
ما سأفعله تاليًا
- تجربة ما إذا كان يمكن جعل سجلات غير قوائم المعرفة (مثل قائمة مسودات المقالات) بالشكل نفسه أيضًا
- التقديم إلى AdSense
ملخص
الرموز تهمّ حتمًا. وإن كان الاستمرار طويلًا ضمن النطاق المجاني، فأكثر.
كانت طريقة التقليل لا تغيير الأداة، بل حيلة في طريقة القراءة. جعل الجدول فهرسًا للقائمة وقراءة الصفوف اللازمة فقط. وإبقاء النص الأصلي في MD. بهذا التقسيم صارت كمية قراءة التحقق من بند واحد نحو 1/230.
الأجر بالساعة ما زال 0円. أبقي ذلك الصدق كما هو، وأتقدم إلى المقال التالي.
- 22 نوفمبر 2026 ― النسخة العربية (ترجمة للنسخة اليابانية No.17 أُعيدت كتابتها لتُقرأ بطبيعية بالعربية)(8,864 حرف)
→ العودة إلى قائمة المقالات / → العودة إلى الصفحة العربية الرئيسية