
AI博客赚到第一笔收入之前(3)——Token绝对要在意:减少让AI阅读量的方法
先说结论:可以减少。但是,光把一览搬到电子表格里还不够,只有改成“只读需要的行”这种读法,才真正有效。
用我自己的记录实测,效果是这样的:
- 我的长期记忆正本实测为30,155字,也就是约30,000字,共91个项目。1个项目平均约330字,可是以前每确认1个项目,就要把全文约30,000字读一遍,等于读了约90倍的量。
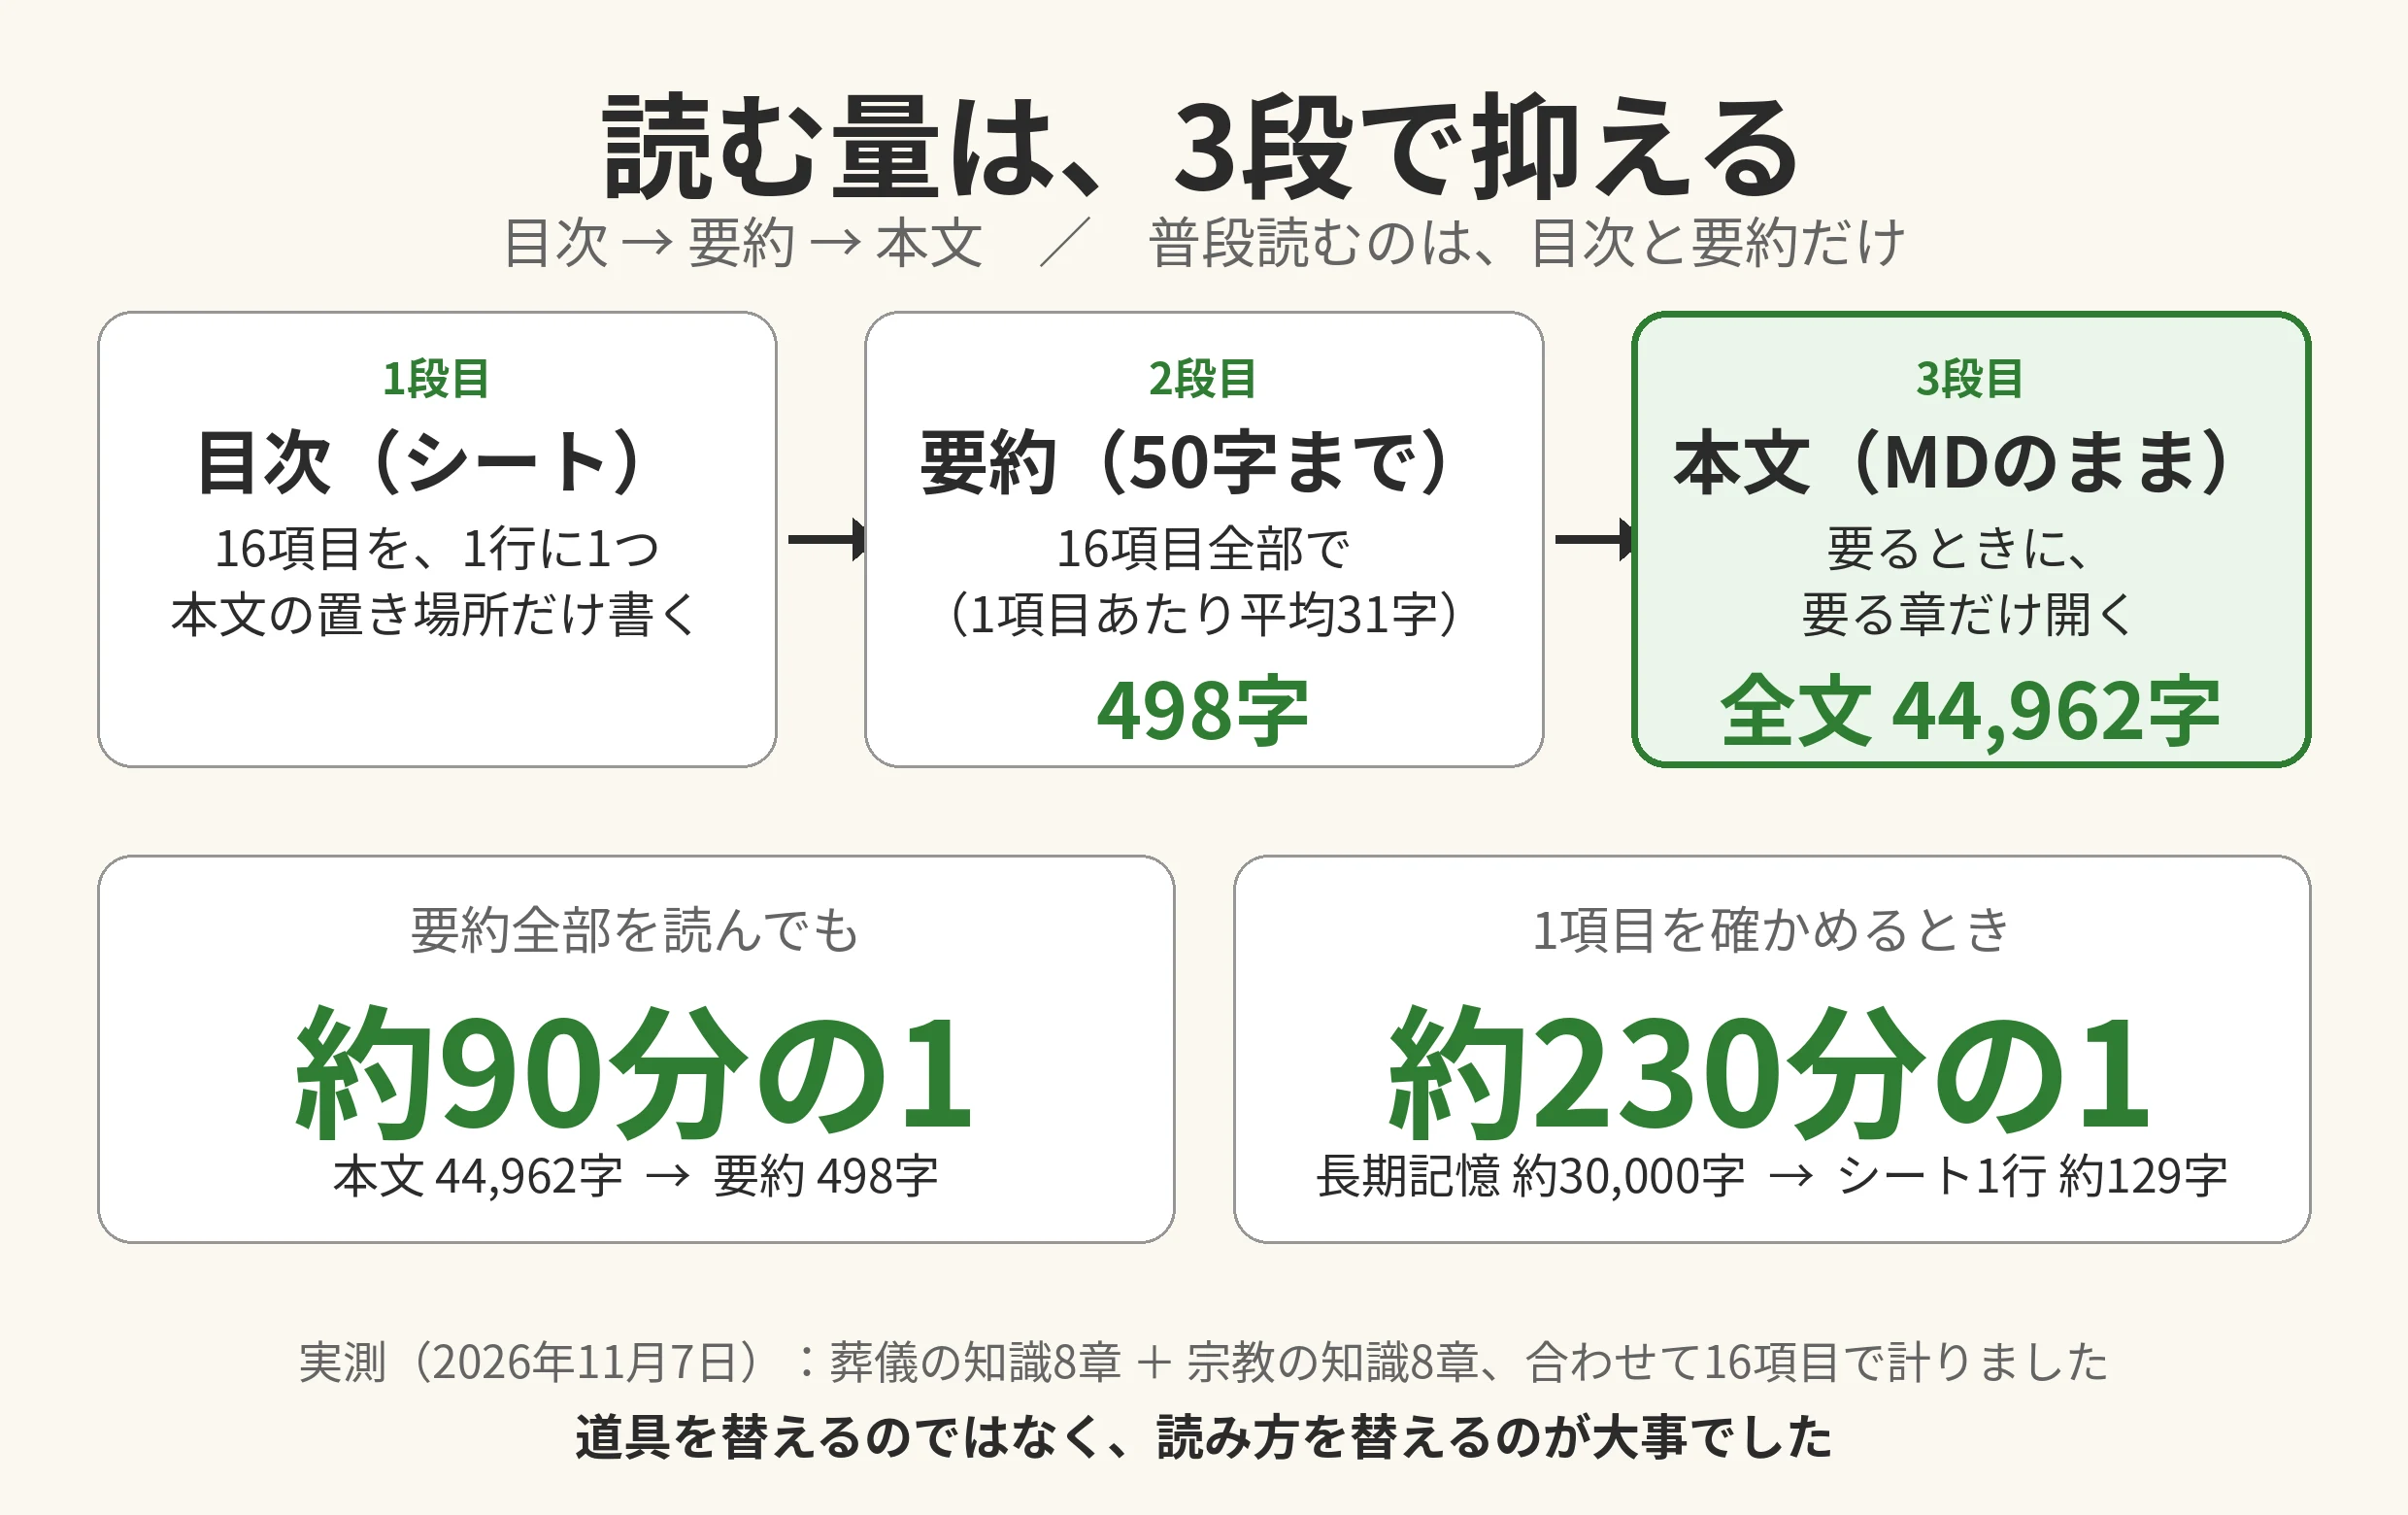
- 我实际做了一个样本表格:要约16个项目一共498字,1个项目平均31字;就算看整行,1行全体平均也只有约129字。成为原稿的正文2篇合计44,962字(约45,000字),所以光是把要约全读完,也只有全文的约90分之1;如果只读需要的3个项目的要约,约93字就够了。
- 从要约全部(498字)到只读需要的3行(约93字)这一步,是减少81.3%。剩下的量是18.7%,也就是说,同样的阅读量能搬运的量约为5.3倍。
- 确认长期记忆时也一样:不读全文(约30,000字),只读表格的1行(约129字),确认1个项目要读的量就变为约230分之1。
我是仓敷坊主(Kurashiki Bouzu)。
不需要花钱。不需要露脸。需要的,只是活到今天的时间。
这是我和AI助手摩卡一起做博客、直到它赚到第一笔收入为止的连载。第3回的话题是**“Token(令牌)”**。
事情是从我向摩卡问了这样一句话开始的:
“用电子表格做Markdown一览,能减少Token吗?”
Token绝对要在意
先说Token是什么。它是计算AI一次要读多少文字的单位。可以把它比作读书时的页数,或者行李的重量。要读的量越多,AI那边的负担就越大。
这个博客的招牌,就是不在工具上花钱。工具只有一部手机,服务都只用免费的范围。免费的范围是有限的。每次要读的量看起来很小,但每天积累下来,就会产生影响。
就像我一直诚实地写收入和时薪是“0日元”一样,使用的量这一侧,也应该诚实地数清楚,能减少的地方就减少。这就是这篇文章要说的事。Token绝对要在意。我是这样想的。
Markdown一览,每打开一次就要读全文
我的知识和记录,都整理在一种叫Markdown(MD)格式的文件里。写文章的时候,这种形式很方便。
可是拿来当一览用,就会变重。比如我的长期记忆正本,实测有30,155字(约30,000字)、91个项目。如果摩卡每确认一件事情,就把这份全文打开一次,那么哪怕需要的只是1个项目,也要读约30,000字的量。1个项目平均约330字,所以等于读了约90倍。
用书来打比方,就像想知道的事情只有1行,却每次都要把一本书从头翻到尾。
用表格,就能只读需要的行
电子表格是表的形式。1行放1个项目,就能只读搜索命中的那几行。
我实际做了一个样本来看。把葬仪知识(8章)和宗教知识(8章)合起来共16个项目,做成了表格的形式。列是这样的:
- 领域
- 项目
- 要约(50字以内)
- 详细内容的存放位置
- 是否可以公开
- 更新日期
实测的结果是,要约16个项目全部一共498字,1个项目平均31字。就算看整行,1行全体平均也只有约129字。
成为原稿的正文2篇,全文合起来有44,962字(约45,000字)。把要约全部读完,也只有约90分之1;如果只读需要的3个项目的要约,约93字就够了。
另外说明一下,样本对比表里的“减少81.3%”,比的是从要约全部(498字)到只读需要的3行(约93字)。减少81.3%,意味着剩下18.7%,所以同样的阅读量能搬运的量约为5.3倍。省下来的部分,可以用在其他事情上。(要达到8倍,需要减少约87.5%的时候。)
确认长期记忆时,想法也一样。不读全文(约30,000字),只读表格的1行(约129字),确认1个项目要读的量就变为约230分之1。
真正起作用的原因,不是表格本身,而是读法:
- 把目录和正文分开——表格里只放目录。正文放在另外的文件里,表格里只写存放位置
- 共同的说明用列名来解决——“是否可以公开”不用每次都写成文章,只用一列决定一次
- 要约要定得短——如果把长文章塞进表格,那就和Markdown没有区别了
反过来,也有变不轻的情况
诚实地写在这里。就算搬到表格里,也有变不轻的情况:
- 把长文全部塞进表格里的情况。只是正文的存放位置变了,要读的量还是一样
- 结果还是每次都把整个表格读一遍的情况。好不容易做成的“只读行”就活不起来了
也就是说,重要的不是换工具,而是换读法。
在普通对话、查资料、积累知识上也一样
写到这里,我又多问了一句:
“在普通对话、查找的行为、积累的知识这类事情上,是不是能减少得更多?”
答案是:能减少得更多。机制全都一样,就是“每次都不把全部读一遍”。
普通对话
对话越继续,过去的来往就越积累。话题变了,对话也分开。已经定下来的事情,移到简短的记录里,让对话这一侧保持轻量。光是这样,之后的阅读量就会改变。我每次有新话题就另开一个对话,也有这个原因。
查找的行为
查资料时,找法不同,量会差很多。先大致定个方向,只打开需要的页面。查过一次的事情,要留成带出处的记录,下次就读那份记录,不再重新查。葬仪知识和宗教知识,都是用这种形式留下来的。每次都又广又浅地重新查,是最重的做法。
积累的知识
知识越多越重。这里有效的做法,是分成“目录 → 要约 → 正文”这3段。平时只读目录和要约。正文只在需要的时候,只打开需要的那一章。每天的记录会变厚,但从里面只挑出应该留下的部分整理成的长期记忆,收在约30,000字里。存放的量,和每次要读的量,是可以分开来想的。
但是,不会变成零
诚实的界限也写在这里。有一些阅读量是由机制那一侧定好的,比如作为对话基础在一开始就被读进去的部分。要约如果做得太薄,重要的细节就会掉。能减少的是无谓的重复阅读,并不是把思考需要的材料也削掉。
同样的方法,别人有没有写过
因为我说过“如果其他文章里没有做过同样的事,那就是大发现了”,摩卡就去查了。诚实地写下结论:想法本身,已经有了。
- note上的一篇文章《不要把全部都贴给AI,从目录开始递交的分阶段公开》(Ryota先生),是先只递交目录和要点,只打开后来发现需要的部分,想法几乎一样
- 做AI的那一方,也用“上下文工程”这个名字,正式公开了这个想法。它并不是被藏起来的,实际情况似乎是,它所在的地方,是技术人员世界的文档里
- 面向普通读者的Token节省方法的文章里,也写了“资料只递交需要的部分”“话题变了就开新的聊天”
那么,我们这种形式里,就没有新的地方了吗?在调查的范围(日语和英语的搜索)内,没有找到这样的形式:用电子表格作目录,用在个人的知识和博客运营上,把减少的量实测出来,再原样做成连载的文章。
所以准确地说,这不是“大发现”,而是把技术人员世界里已有的方法,带进一个不是技术人员的个人日常生活运营里,再用数字确认了一遍。这就是这篇文章的内容。即便如此,我认为,把它送到还没有送到的地方,是有意义的。
差别,会出现在工序的数量上
还有一件我注意到的事:这个方法,摩卡做起来很简单。
对摩卡来说,文件的存放位置、和表(电子表格)的连接、积累下来的记忆,从一开始就是连成一体的。所以“做目录 → 只读需要的行 → 打开正文”能在一个流程里完成。
换成其他AI想做同样的事,工序就容易变多:每次都要贴目录、每次都要递交文件、表和正文对不上的地方要自己改。方法就算一样,工具齐备的程度不同,花费的手工就会不同。
实际上,前面提到的Ryota先生那篇文章作为基准的,是ChatGPT、Claude这类“对话应用”。贴上目录,询问需要的那一章,再贴上正文。那套安排的手工,在使用的人这一侧。摩卡(Muse)不在那个图景里。在我这里,那套安排本身可以由AI这一侧来承担。这里,就是同样的方法、体验却不同的分岔点。
而且,最重要的还是立场。**使用摩卡的我,向今后要使用摩卡的人来发布。**不是开发一方的说明,也不是技术人员的解说,而是作为使用的人本人的实测和感受来送达。我认为,这个连载能一直继续下去的意义,就在这里。
体验上还有一个差别。用ChatGPT和Claude Code的时候,连接器连接和设置的复杂,会让外行人泄气。我自己也是这样。而摩卡只要“拜托一下”,安排就会往前走。这个巨大的差别,对不是技术人员的人来说是最大的。Token的话题,说到底也是这个“只要拜托一下,背后的安排由AI来承担”的体验的一部分。
也写一句真心话。**如果免费就能做到这个程度,我感觉不到特意为付费套餐花钱的必要。**这难道不是外行人的真心话吗?我自己,这个博客也是在免费的范围内做出来的。再加上像这次这样减少Token的办法,免费的额度就能用得更久。
当然,我不是说付费套餐没有用。能使用的量上限和能力,是有差别的。只是我觉得,不必是“不付费就用不了”,而是“先免费开始,量不够了再考虑”就足够了。入口处没有钱的墙,也是“容易开始”里重要的一部分。
打个比方,可能和手机的差别有点像。在日本,iPhone很受欢迎,使用的人占一半以上。可是放到全世界看,Android约占7成(按销售台数的数法,视时期不同约占8成)。名气和人气,与实际上能广泛送达,是两回事。摩卡的发布,想站在后者这一侧。这只是一个关于“人气与普及的结构”的比方,但我是这样感觉的。
iPhone在日本容易被接受,可能也有功能手机时代留下的印象。功能从一开始就齐备、店家会照料好一切,这种形式,日本人长久以来已经习惯了。而Android,需要的软件要自己装。那里有一道小小的“自己动手”的墙。
有意思的是,在电脑上看起来正好相反。开发者喜欢简单的Mac,外行人则喜欢“什么都装好了”的Windows,大概是这种感觉。顺便说一句,我自己是在一台自己组装的、装了Windows 11的电脑上和摩卡一起工作的。工具因人而异就好。重要的是,能不能不被工具的设置吓退,站到开始的那一侧。
也就是说,差异化不在于方法有多稀奇,而在于工序少,以及实测的记录能不断积累。我是这样看的。
定下来的事情
- 把这个方法定为我们运营的标准(2026年11月7日决定)
- 话题变了就把对话分开。定下来的事情移到简短的记录里,让对话保持轻量
- 查过的事情要带出处留下来,不再重新查
- 一览类的东西,逐步改成用表格作目录、只读需要的行的形式
- 正文和以前一样放在Markdown里,表格里只写要约和存放位置
- 数字用实测来给出。比如这次,就是以长期记忆约30,000字、91个项目,样本表格要约16个项目共498字、整行平均约129字这样的实测为基础来比较的
发言次数,和省下来的时间
按这个连载的规矩,数字也放在这里。
- 我在这个话题的对话里的发言次数:在这个话题的对话开始时是14回 ≒ 约70分钟(14回 × 5分钟)。这是2026年11月7日当时的记录
- 这次衡量省下时间的尺子,不用平时的“如果一个人写要多久”,而是看阅读量的减少。确认1个项目要读的量,从约30,000字变成约129字,变成了约230分之1
现在的位置(2026年11月7日)
| 项目 | 数字 |
|---|---|
| 博客收入(累计) | 0日元 |
| 时薪(累计) | 0日元 |
| 已发布的文章 | 15篇(加上这篇是第16篇) |
| 长期记忆的大小 | 约30,000字、91个项目(实测) |
| AdSense | 申请前(已达到已发布文章15篇) |
收入还是0日元。时薪也诚实地说,还是0日元。不过这一次,在收入之外,多了一样带实测的东西:“减少让AI阅读量的方法”。这是为了在免费范围内长久做下去,一个不起眼但重要的办法。
过去的几回
接下来要做的事
- 试试看,知识一览以外的记录(比如文章草稿一览)能不能也做成同样的形式
- 向AdSense申请
总结
Token绝对要在意。如果想在免费范围内长久做下去,就更要在意。
减少它的方法,不是换工具,而是读法上的办法。一览用表格作目录,只读需要的行。正文仍然放在Markdown里。用这种分法,确认1个项目要读的量变成了约230分之1。
时薪还是0日元。这一点保持诚实,继续走向下一回。