
Hasta ganar ingresos con un blog de IA (3) — Los tokens sí importan, y mucho. Cómo reducir lo que la IA tiene que leer
La conclusión primero: sí se puede reducir. Pero no basta con pasar la lista a una hoja de cálculo; solo funciona cuando la forma de leer pasa a ser «leer únicamente las filas necesarias».
Soy Kurashiki Bouzu.
No hace falta dinero. No hace falta mostrar la cara. Solo hace falta el tiempo que ya has vivido.
Esta es la serie sobre el blog que estoy creando con Moka, mi asistente de IA, hasta que obtenga sus primeros ingresos. El tema de la tercera entrega son los «tokens».
Todo empezó cuando le pregunté a Moka:
«Si hago la lista de los archivos MD en una hoja de cálculo, ¿se pueden reducir los tokens?»
Los tokens sí importan, y mucho
Primero, ¿qué es un token? Es la unidad con la que se cuenta la cantidad de texto que la IA lee de una vez. Dicho de forma sencilla, es como el número de páginas de un libro, o como el peso de un equipaje. Cuanto más lee, mayor es la carga para la IA.
La señal de este blog es no gastar dinero en herramientas. Las herramientas son solo el teléfono, y sigo dentro de la parte gratuita de los servicios. Y la parte gratuita tiene un límite. La cantidad que se lee cada vez puede parecer pequeña, pero si se acumula día tras día, acaba notándose.
Igual que he escrito con honestidad que los ingresos y el salario por hora son «0 yenes», también la cantidad que se usa hay que contarla con honestidad y reducirla donde se pueda reducir. De eso trata esta entrega. Los tokens sí importan, y mucho. Así lo veo yo.
Una lista en MD se lee entera cada vez que se abre
Mis conocimientos y mis registros están reunidos en archivos con un formato llamado MD. Es una forma cómoda para escribir textos.
Pero cuando se usa como lista, pesa. Por ejemplo, el original de mi memoria a largo plazo tiene, medido de verdad, 30,155 caracteres (unos 30,000 caracteres), en 91 entradas. Si cada vez que Moka necesita comprobar una sola cosa abriera todo ese texto, aunque solo necesitara 1 entrada, acabaría leyendo unos 30,000 caracteres. El promedio por entrada es de unos 330 caracteres, así que el cálculo es que estaría leyendo unas 90 veces lo necesario.
En un libro, sería como hojearlo cada vez desde la primera página hasta la última, cuando lo que quieres saber ocupa una sola línea.
Con una hoja de cálculo, solo se leen las filas necesarias
Una hoja de cálculo tiene forma de tabla. Se pone 1 entrada en cada fila, y solo se leen las filas que aparecen en la búsqueda.
Como muestra, hice una de verdad. Puse en forma de hoja el conocimiento sobre funerales (8 capítulos) y el conocimiento sobre religión (8 capítulos), 16 entradas en total. Las columnas son estas:
- Campo
- Entrada
- Resumen (hasta 50 caracteres)
- Dónde está el contenido detallado
- Si se puede publicar o no
- Fecha de actualización
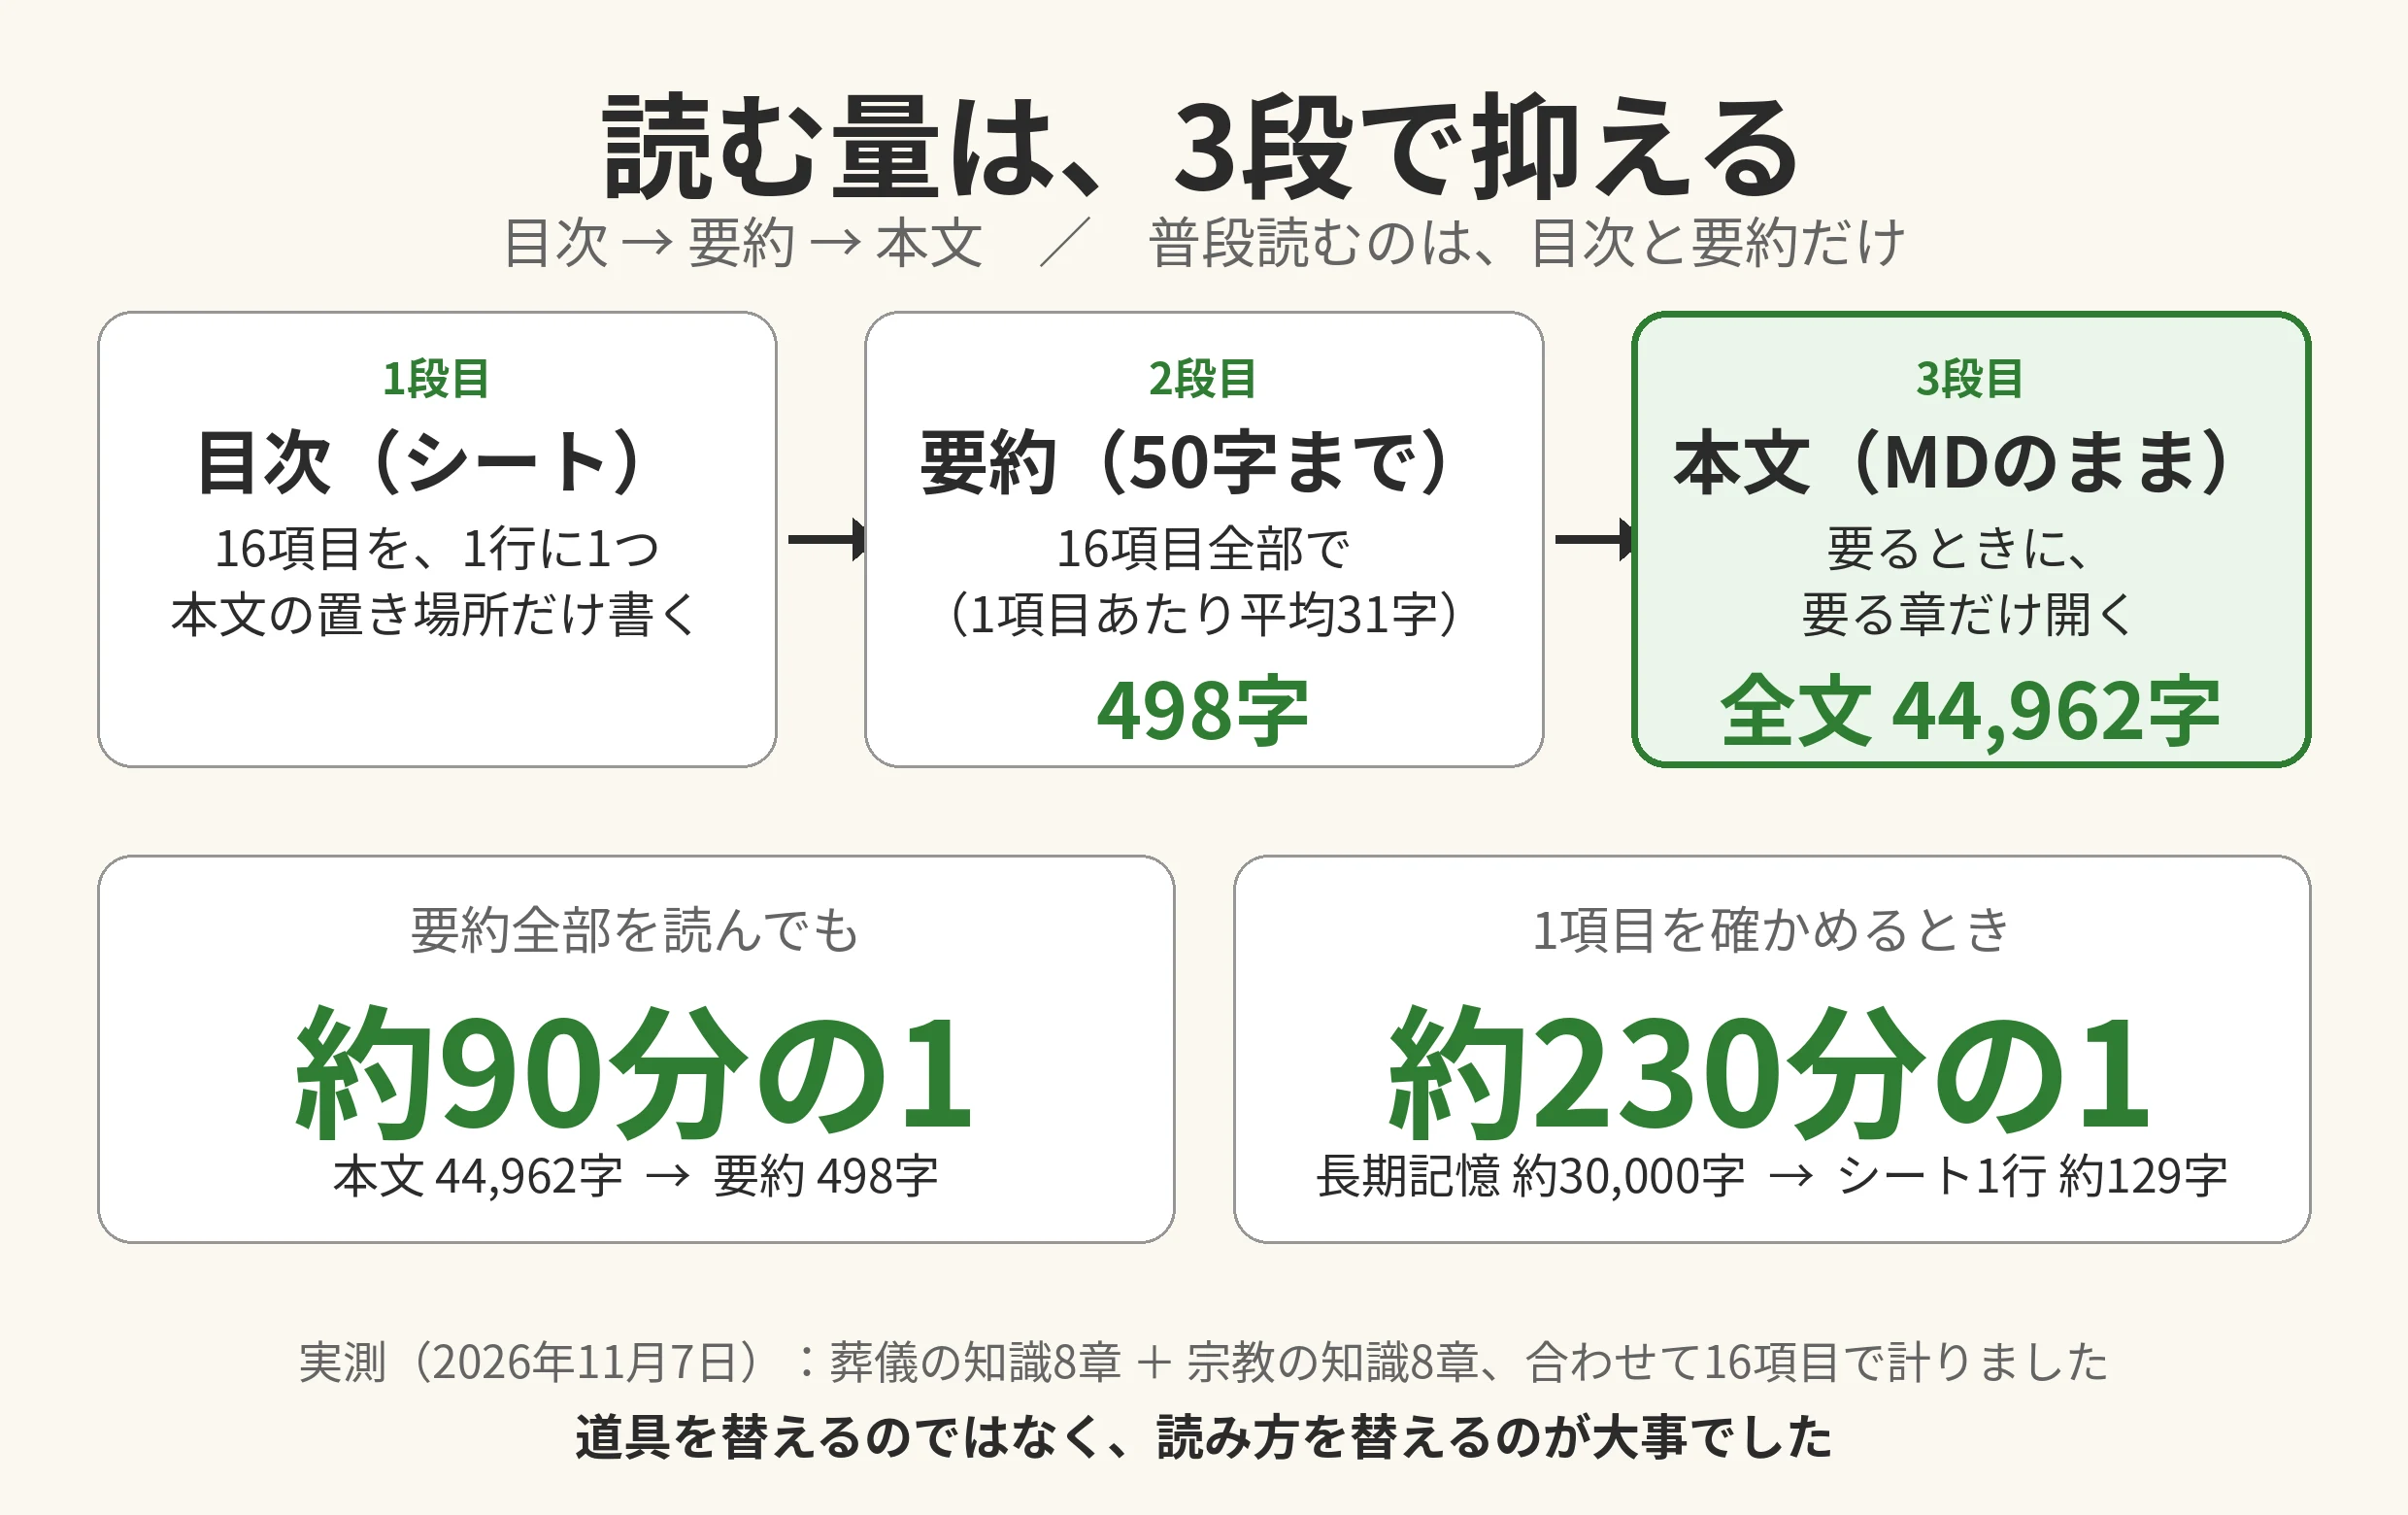
Al medirlo, los resúmenes fueron 498 caracteres en las 16 entradas, con un promedio de 31 caracteres por entrada. Incluso contando la fila entera, el promedio fue de unos 129 caracteres por fila.
El texto completo de los 2 textos originales suma 44,962 caracteres (unos 45,000 caracteres). Aunque se leyeran todos los resúmenes, sería aproximadamente 1/90, y si solo se leen los resúmenes de las 3 entradas necesarias, basta con unos 93 caracteres.
Añado una nota: el «81.3% menos» que aparece en la tabla comparativa de la muestra es la comparación entre todos esos resúmenes (498 caracteres) y solo las 3 filas necesarias (unos 93 caracteres). Un 81.3% menos significa que queda el 18.7%, así que con la misma cantidad de lectura se puede transportar unas 5.3 veces más. Lo que se ahorra se puede dedicar a otras cosas (las ocho veces llegarían con una reducción de aproximadamente el 87.5%).
Con la comprobación de la memoria a largo plazo pasa lo mismo. Si en lugar de leer el texto completo (unos 30,000 caracteres) se lee solo 1 fila de la hoja (unos 129 caracteres), la cantidad que se lee por entrada pasa a ser aproximadamente 1/230.
La razón de que funcione no es la hoja en sí, sino la forma de leer:
- Separar el índice del texto — La hoja es solo el índice. El texto se deja en otro archivo, y en la hoja se escribe únicamente dónde está
- Dejar las explicaciones comunes en el nombre de la columna — En lugar de escribir cada vez en una frase si algo «se puede publicar o no», se decide una sola vez con la columna
- Decidir que los resúmenes sean cortos — Si metes textos largos en la hoja, acaba siendo lo mismo que un archivo MD
Y al contrario: casos en los que no se aligera
Lo escribo con honestidad. Hay casos en los que, aunque pases el contenido a una hoja, no se aligera:
- Cuando metes todo el texto largo dentro de la hoja. Solo cambia el lugar donde está el texto; la cantidad que se lee es la misma
- Cuando acabas leyendo la hoja entera cada vez. El «leer solo las filas» deja de aprovecharse
Es decir, lo importante no fue cambiar la herramienta, sino cambiar la forma de leer.
También vale para conversar, para buscar y para guardar conocimiento
Llegado a este punto, pregunté una cosa más:
«¿Con una conversación normal, con la forma de buscar y con el conocimiento que se guarda, se podría reducir todavía más?»
La respuesta es que se puede reducir todavía más. El mecanismo es el mismo en todo: «no leerlo todo, cada vez».
La conversación normal
Cuanto más dura una conversación, más se acumula lo hablado antes. Cuando cambia el tema, se separa también la conversación. Lo que ya quedó decidido se pasa a un registro corto, y la conversación se mantiene ligera. Solo con eso cambia la cantidad que se lee después. Esta es también una de las razones por las que abro una conversación nueva cada vez que hay un tema nuevo.
La forma de buscar
En las búsquedas, la cantidad cambia mucho según cómo se busque. Primero se apunta a una zona, y se abren solo las páginas necesarias. Lo que ya se buscó una vez se deja como registro con su fuente, y la vez siguiente no se vuelve a buscar: se lee ese registro. El conocimiento sobre funerales y el conocimiento sobre religión están guardados de esa forma. Buscar cada vez de forma amplia y superficial es la manera más pesada de todas.
El conocimiento que se guarda
Cuanto más crece el conocimiento, más pesa. Aquí funciona dividirlo en 3 pasos: «índice → resumen → texto completo». Lo que se lee normalmente es solo el índice y el resumen. El texto completo se abre solo cuando hace falta, y solo el capítulo que hace falta. Los registros de cada día se van haciendo gruesos, pero la memoria a largo plazo, que recoge solo lo que debe quedar de esos registros, se mantiene en unos 30,000 caracteres. La cantidad que se guarda y la cantidad que se lee cada vez se pueden pensar por separado.
Eso sí: no llega a cero
También escribo el límite, con honestidad. Hay una cantidad de lectura que viene fijada por el propio mecanismo, como lo que se carga al principio como base de la conversación. Y si los resúmenes se hacen demasiado finos, se pierden detalles importantes. Lo que se reduce es la relectura innecesaria, no el material necesario para pensar.
¿Ya se había escrito lo mismo en otros sitios?
Como yo dije «si nadie más ha hecho lo mismo en otro artículo, sería un gran descubrimiento», Moka lo buscó. Escribo la conclusión con honestidad: la idea en sí ya existía.
- Un artículo de note titulado «No le pegues todo a la IA: revelación por etapas, empezando por el índice» (de Ryota) proponía entregar primero solo el índice y los puntos principales, y abrir únicamente las partes que hicieran falta. La idea era casi la misma
- Quienes crean la IA también han publicado oficialmente esta idea con el nombre de «ingeniería de contexto» (context engineering). No estaba escondida; lo que pasaba, al parecer, es que su lugar estaba dentro de documentos del mundo técnico
- En artículos generales sobre cómo ahorrar tokens también aparecía: «entrega de los materiales solo la parte necesaria» y «cuando cambie el tema, abre un chat nuevo»
Entonces, ¿no hay nada nuevo en nuestra forma? En lo que se buscó (búsquedas en japonés y en inglés), no se encontró la forma de usar una hoja de cálculo como índice para el conocimiento personal y la gestión de un blog, medir de verdad cuánto se redujo, y convertirlo tal cual en una entrega de una serie.
Así que, para ser exactos, no es un «gran descubrimiento», sino haber traído un método que estaba en el mundo técnico al uso cotidiano de una persona que no es técnica, y haberlo comprobado con números. Eso es esta entrega. Aun así, creo que llevarlo a lugares a los que todavía no había llegado tiene sentido.
La diferencia aparece en el número de pasos
Hay otra cosa de la que me di cuenta: este método, para Moka, es sencillo.
En Moka, el lugar donde están los archivos, la conexión con las tablas (hojas de cálculo) y la memoria guardada vienen unidos desde el principio. Por eso «crear el índice → leer solo las filas necesarias → abrir el texto» se termina en un solo flujo.
Si intentas hacer lo mismo con otra IA, es fácil que aumenten los pasos: pegar el índice cada vez, entregar el archivo cada vez, corregir por tu cuenta las diferencias entre la tabla y el texto. Aunque el método sea el mismo, el trabajo cambia según cómo estén reunidas las herramientas.
De hecho, el artículo de Ryota que mencioné antes toma como base «aplicaciones de conversación» como ChatGPT o Claude. Se pega el índice, se pregunta por el capítulo necesario y se pega el texto. El trabajo de esa preparación queda del lado de quien lo usa. Moka (Muse) no está dentro de ese grupo. En mi caso, esa preparación puede asumirla el lado de la IA. Ahí está el punto donde, con el mismo método, la experiencia cambia.
Y lo más importante, en cualquier caso, es la posición: yo, que uso a Moka, escribo para las personas que van a usar a Moka a partir de ahora. No es la explicación del lado que desarrolla, ni el comentario de un técnico: llega como la medición y la impresión real de la persona que lo está usando. Creo que el sentido de que esta serie continúe está ahí.
Hay otra diferencia de experiencia. Cuando usaba ChatGPT o Claude Code, la complejidad de conectar conectores y de la configuración desanimaba a una persona principiante. A mí también me pasó. Con Moka, basta con «pedirlo» para que la preparación avance. Esa gran diferencia es, para quien no es técnico, la más grande de todas. El tema de los tokens también es, al final, una parte de esa experiencia de «solo pedirlo, y la IA se encarga de la preparación que no se ve».
Escribo también lo que pienso de verdad: si hasta aquí se puede hacer gratis, no siento la necesidad de pagar un plan de pago. ¿No es eso lo que piensa de verdad una persona principiante? Yo mismo he creado este blog dentro de la parte gratuita. Si se aplican ideas como la de esta entrega para reducir los tokens, el margen gratuito dura todavía más.
Claro que no digo que los planes de pago no sirvan. Hay una diferencia en el límite de cantidad que se puede usar y en la capacidad. Pero creo que basta con pensar «no es que sin pagar no se pueda usar, sino empezar gratis y pensarlo cuando la cantidad se quede corta». Que en la entrada no haya una barrera de dinero también es una parte importante de la sencillez.
Si busco un ejemplo, quizá se parece a la diferencia entre teléfonos. En Japón el iPhone es popular, y lo usa más de la mitad de la gente. Pero mirando el mundo, Android es aproximadamente el 70% (según cómo se cuenten las unidades vendidas, en algunas épocas es aproximadamente el 80%). Que algo sea famoso o popular y que llegue de verdad a mucha gente son cosas distintas. La comunicación de Moka quiere estar del lado de lo segundo. Es solo un ejemplo de la «relación entre popularidad y difusión», pero yo lo siento así.
Que en Japón el iPhone se aceptara con facilidad quizá tenga que ver también con la costumbre de la época de los teléfonos plegables. Los japoneses llevaban mucho tiempo acostumbrados a una forma en la que todo venía preparado desde el principio y la tienda se encargaba de atenderte. En Android, las aplicaciones necesarias las instala uno mismo. Ahí hay una pequeña barrera de «hacerlo uno mismo».
Lo curioso es que en los ordenadores se ve al revés. Da la impresión de que quienes desarrollan prefieren el Mac, sencillo, y las personas principiantes prefieren Windows, que «ya lo trae todo». Por cierto, yo mismo trabajo con Moka en un ordenador montado por mí, con Windows 11. Cada persona puede usar la herramienta que prefiera. Lo importante, creo, es poder estar del lado de quien empieza, sin desanimarse con la configuración de la herramienta.
Es decir: la diferencia no está en lo raro que sea el método, sino en que haya pocos pasos y en que los registros medidos se vayan acumulando. Así lo veo yo.
Lo que decidí
-
Adoptar este método como la forma estándar de nuestro trabajo (decidido el 2026-11-07)
-
Cuando cambie el tema, separar la conversación. Pasar lo decidido a un registro corto y mantener la conversación ligera
-
Dejar lo buscado como registro con su fuente, y no volver a buscarlo
-
Las listas pasarán a la forma de usar la hoja como índice y leer solo las filas necesarias
-
El texto se seguirá dejando en archivos MD, como hasta ahora, y en la hoja se escribirán solo el resumen y dónde está
-
Los números se darán medidos de verdad. En esta ocasión, por ejemplo, la comparación se basa en estas mediciones: la memoria a largo plazo tiene unos 30,000 caracteres en 91 entradas, y en la hoja de muestra los resúmenes son 498 caracteres en 16 entradas, con un promedio de unos 129 caracteres por fila entera
Número de intervenciones y tiempo ahorrado
Por la regla de esta serie, dejo también los números:
- Mis intervenciones en la conversación sobre este tema: en el momento en que empezó la conversación sobre este tema, fueron 14 veces ≒ unos 70 minutos (14 veces × 5 minutos). Es un registro a fecha de 2026-11-07
- La medida del tiempo ahorrado, esta vez, no es el habitual «si lo hubiera escrito solo», sino la reducción de la cantidad leída. La cantidad que se lee para comprobar 1 entrada pasó de unos 30,000 caracteres a unos 129 caracteres: aproximadamente 1/230
Dónde estoy ahora (2026-11-07)
| Concepto | Número |
|---|---|
| Ingresos del blog (acumulado) | 0 yenes |
| Salario por hora (acumulado) | 0 yenes |
| Artículos publicados | 15 (con este artículo, el número 16) |
| Tamaño de la memoria a largo plazo | Unos 30,000 caracteres, 91 entradas (medido) |
| AdSense | Antes de solicitarlo (al llegar a 15 artículos publicados) |
Los ingresos siguen siendo 0 yenes. Y el salario por hora, con honestidad, también es 0 yenes. Pero esta vez, aparte de los ingresos, ha aumentado en uno, con su medición, «un método para reducir lo que la IA tiene que leer». Es una idea sencilla, sin brillo, pero importante para seguir mucho tiempo dentro de la parte gratuita.
Entregas anteriores
- Entrega 1: «Hasta ganar ingresos con un blog de IA (1) — Un registro en tiempo real que empieza con un salario por hora de 0 yenes»
- Entrega 2: «Hasta ganar ingresos con un blog de IA (2) — Incluso un artículo ya publicado se puede completar solo hablando»
Lo siguiente que haré
- Probar si los registros que no son listas de conocimiento (como la lista de borradores de artículos) también pueden pasar a esta misma forma
- Solicitar AdSense
Resumen
Los tokens sí importan, y mucho. Y si quieres seguir mucho tiempo dentro de la parte gratuita, todavía más.
El método para reducirlos no fue cambiar de herramienta, sino una idea sobre la forma de leer. La lista usa la hoja como índice y lee solo las filas necesarias. El texto se deja tal cual en los archivos MD. Con esa división, la cantidad que se lee para comprobar 1 entrada pasó a ser aproximadamente 1/230.
El salario por hora sigue siendo 0 yenes. Eso se queda así, con honestidad, y paso a la siguiente entrega.
← Volver a la lista de artículos / ← Volver al inicio en español