
AI ब्लॉग से आय पाने तक (3) ― टोकन की चिंता तो होगी ही। AI को पढ़ाई जाने वाली मात्रा घटाने का तरीक़ा
नमस्ते, मैं कुराशिकी बोज़ू हूँ।
पैसा नहीं चाहिए। चेहरा भी नहीं दिखाना। चाहिए सिर्फ़, जिया हुआ समय।
यह उस ब्लॉग की शृंखला है जिसे मैं AI बटलर मोका के साथ बना रहा हूँ, पहली आय पाने तक की। तीसरी कड़ी का विषय है, «टोकन»।
यह मैंने मोका से इस तरह पूछने से शुरू हुआ।
«स्प्रेडशीट में MD की सूची बनाएँ तो टोकन घटेगा?»
निष्कर्ष पहले लिखता हूँ। घटेगा। लेकिन, सूची को सिर्फ़ शीट में ले जाने से काम नहीं होगा, «सिर्फ़ ज़रूरी पंक्तियाँ पढ़ने» के आकार में करके ही असर होगा।
टोकन की चिंता तो होगी ही
पहले, टोकन क्या है। यह उस अक्षर-मात्रा को गिनने की इकाई है जो AI एक बार में पढ़ता है। उदाहरण के लिए, किताब पढ़ते समय के पृष्ठों की संख्या या सामान के वज़न जैसी चीज़ है। पढ़ने की मात्रा बढ़ने पर AI की ओर का बोझ बढ़ता है।
इस ब्लॉग का साइनबोर्ड है कि औज़ारों पर पैसा नहीं लगाया जाता। औज़ार सिर्फ़ स्मार्टफ़ोन है, और सेवाओं के मुफ़्त दायरे में जारी रखा जा रहा है। मुफ़्त दायरे की एक सीमा है। हर बार की पढ़ने की मात्रा छोटी दिखे, फिर भी रोज़ जमा होने पर असर करती है।
आय और प्रति-घंटा मज़दूरी को «0円» ईमानदारी से लिखते आने की तरह, इस्तेमाल करने वाले पक्ष की मात्रा भी ईमानदारी से गिनकर, जहाँ घटाना है वहाँ घटाना। यही इस बार की बात है। टोकन की चिंता तो होगी ही। मैं ऐसा सोचता हूँ।
MD की सूची, खोलते ही पूरा पाठ पढ़ती है
मेरा ज्ञान और रिकॉर्ड MD नामक प्रारूप की फ़ाइलों में व्यवस्थित है। लेख लिखने के लिए यह सुविधाजनक आकार है।
लेकिन, सूची के रूप में इस्तेमाल करने पर यह भारी हो जाती है। उदाहरण के लिए, मेरी दीर्घकालिक स्मृति का मूल पाठ असली माप में लगभग 30,000 अक्षर, 91 आइटम है। मोका हर बार कुछ एक जाँचने पर इस पूरे पाठ को खोले, तो ज़रूरत 1 आइटम की होने पर भी लगभग 30,000 अक्षर पढ़ने होंगे। 1 आइटम का औसत लगभग 330 अक्षर है, इसलिए हिसाब है कि लगभग 90 गुना पढ़ा जा रहा है।
किताब की भाषा में कहें तो, जानना सिर्फ़ 1 पंक्ति है, फिर भी हर बार किताब को शुरू से अंत तक पलटने जैसा है।
शीट हो तो, सिर्फ़ ज़रूरी पंक्तियाँ पढ़ी जा सकती हैं
स्प्रेडशीट तालिका का आकार है। 1 पंक्ति में 1 आइटम डालकर, खोज में मिली पंक्तियों को ही पढ़ा जा सकता है।
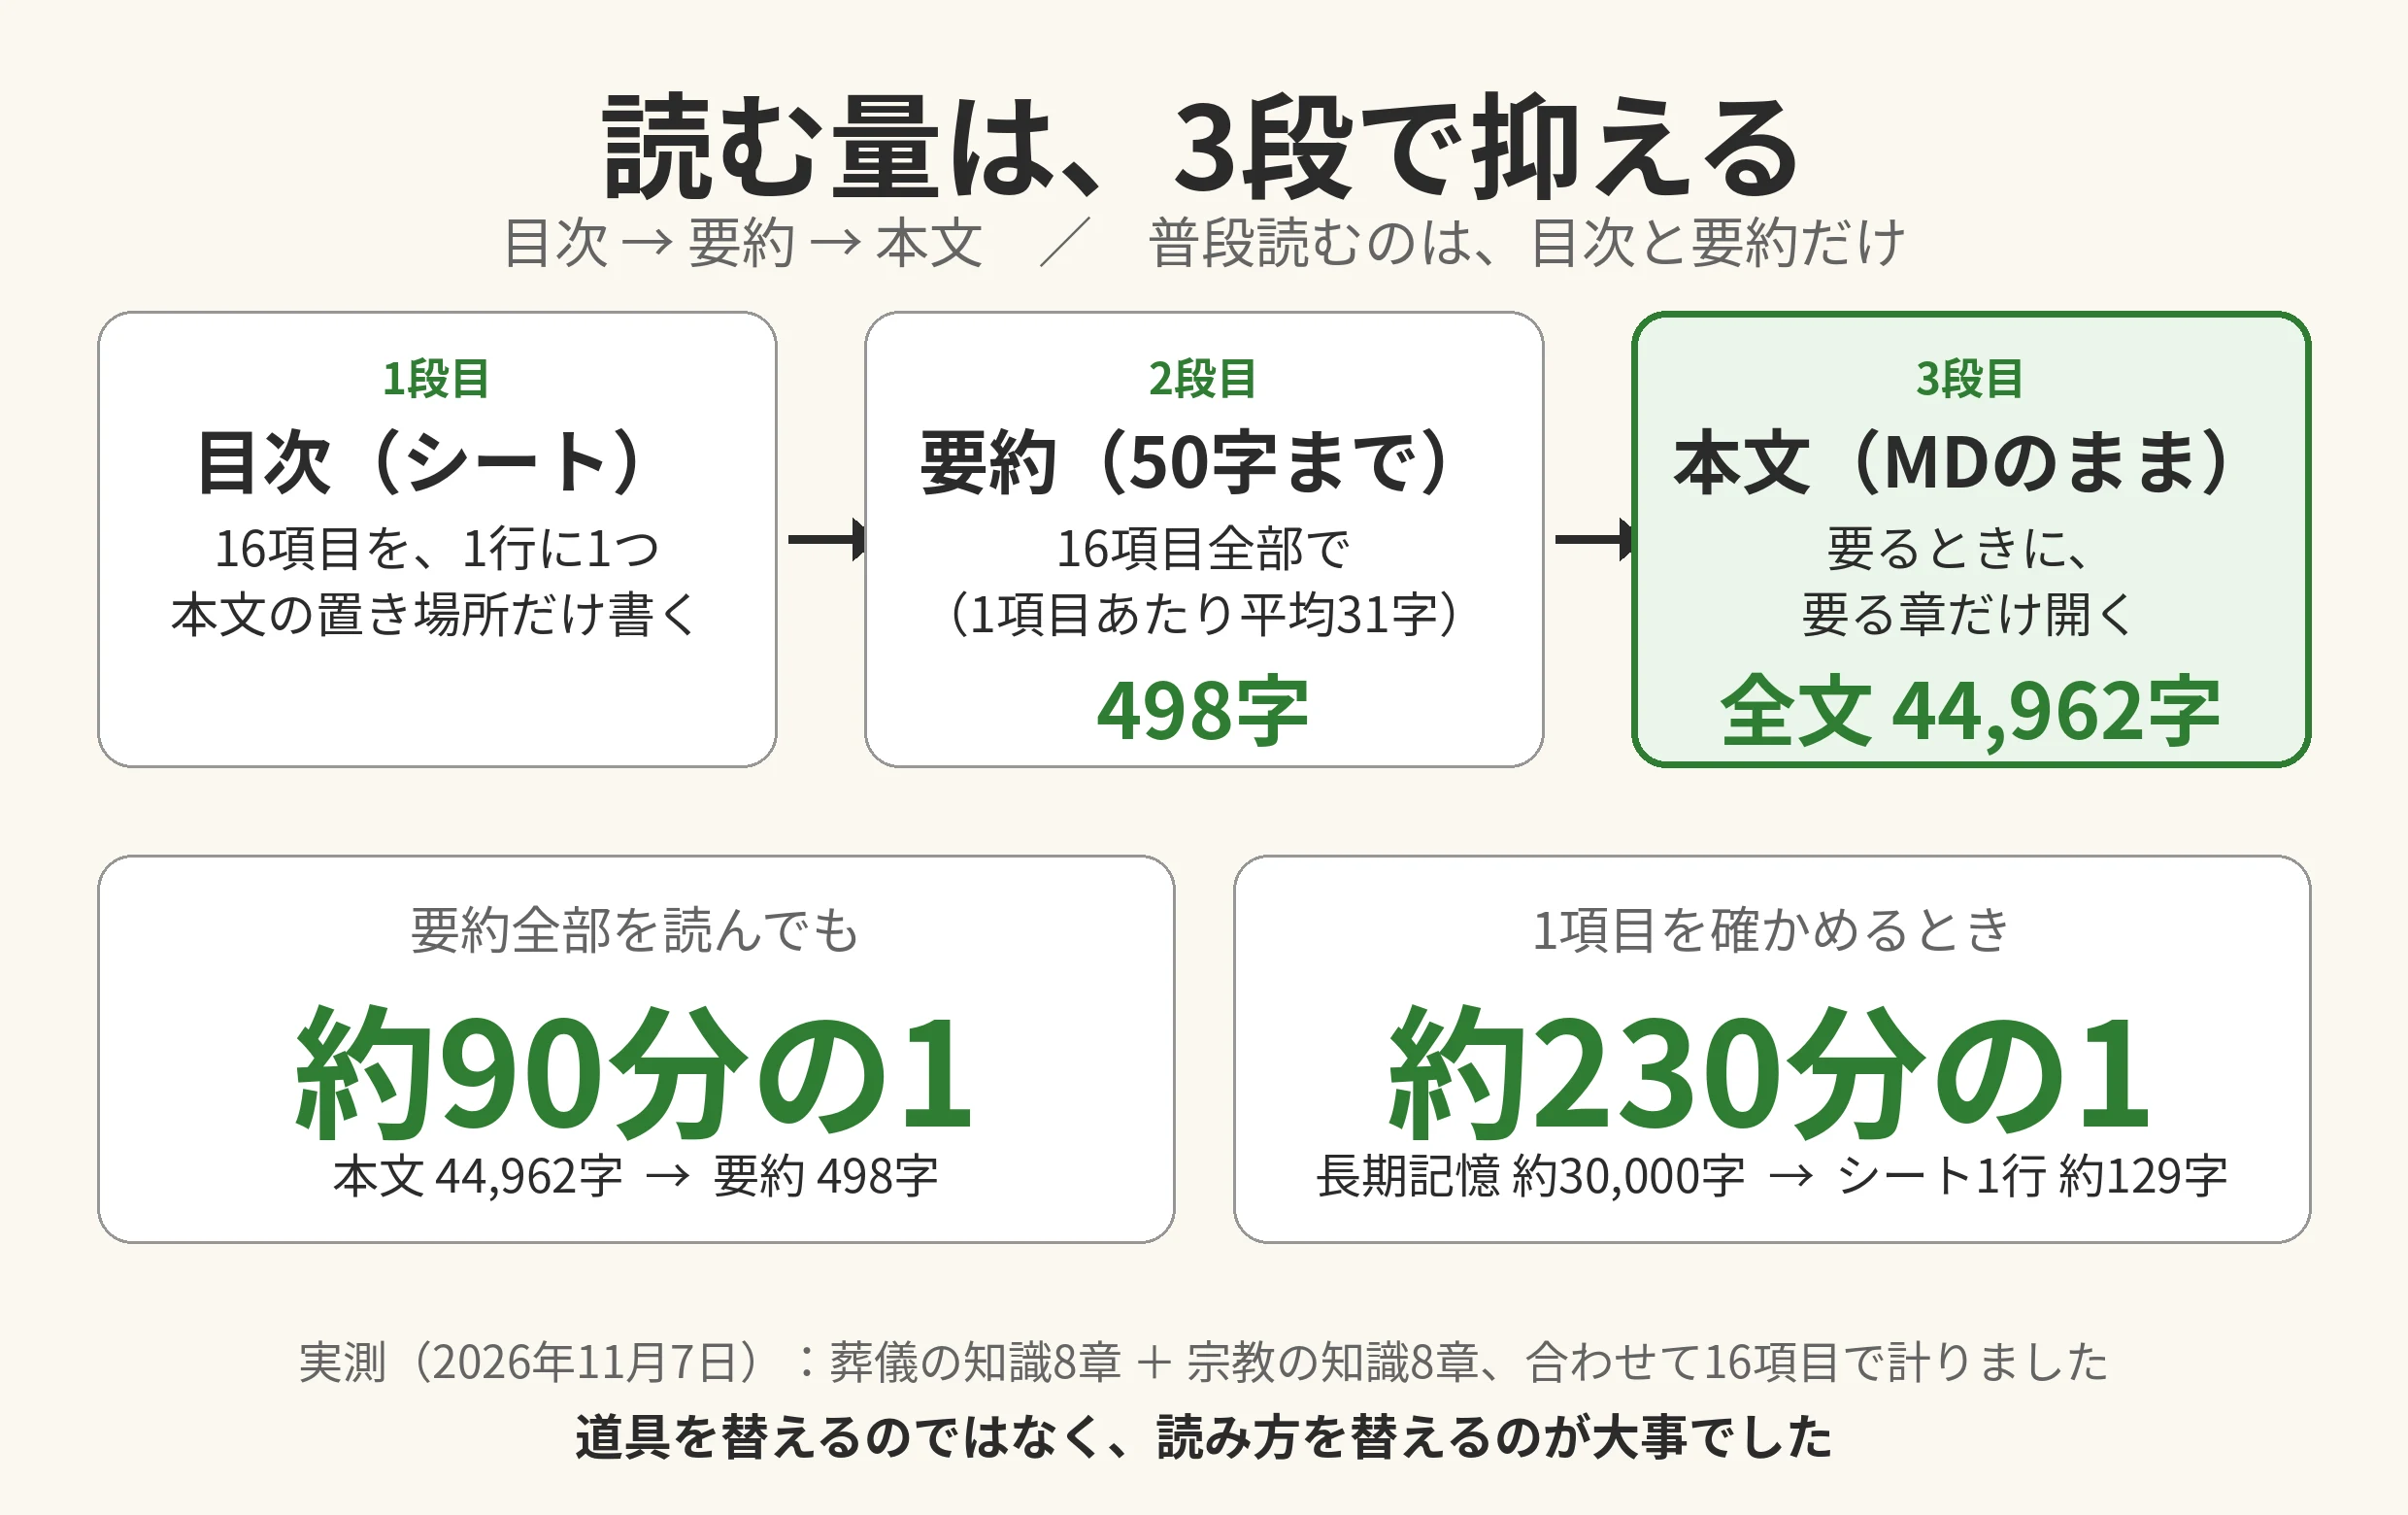
नमूने के तौर पर, सच में बनाकर देखा। अंतिम-संस्कार के ज्ञान (8 अध्याय) और धर्म के ज्ञान (8 अध्याय), कुल 16 आइटम को शीट के आकार में किया हुआ है। स्तंभ इस प्रकार हैं।
- क्षेत्र
- आइटम
- सारांश (50 अक्षर तक)
- विस्तृत सामग्री की जगह
- प्रकाशित करना ठीक है या नहीं
- अद्यतन तिथि
असली माप करने पर, सारांश 16 आइटमों में कुल 498 अक्षर, 1 आइटम का औसत 31 अक्षर था। पूरी 1 पंक्ति में भी औसत लगभग 129 अक्षर है।
मूल बने 2 मूल पाठों का पूरा पाठ मिलाकर लगभग 45,000 अक्षर है। सारे सारांश पढ़ने पर भी लगभग 90वाँ हिस्सा, और सिर्फ़ ज़रूरी 3 आइटमों के सारांश हों तो लगभग 93 अक्षरों में काम हो जाता है।
वैसे, नमूने की तुलना-तालिका में मौजूद «81.3% कमी» इन सारे सारांशों (498 अक्षर) से ज़रूरी 3 पंक्तियों (लगभग 93 अक्षर) की तुलना है। 81.3% कमी का मतलब है कि बचा हुआ 18.7% है, इसलिए उसी पढ़ने की मात्रा में ले जाई जा सकने वाली मात्रा लगभग 5.3 गुना हो जाती है। बचे हुए हिस्से को दूसरी चीज़ों में लगाया जा सकता है, यही बात है (8 गुना तब होता है जब कमी लगभग 87.5% हो)।
दीर्घकालिक स्मृति की जाँच में भी यही सोच है। पूरे पाठ (लगभग 30,000 अक्षर) के बजाय शीट की 1 पंक्ति (लगभग 129 अक्षर) ही पढ़ें तो, 1 आइटम की पढ़ने की मात्रा लगभग 230वाँ हिस्सा हो जाती है।
असर की वजह शीट ख़ुद नहीं, पढ़ने का तरीक़ा है।
- विषय-सूची और मूल पाठ को अलग करना ― शीट सिर्फ़ विषय-सूची है। मूल पाठ दूसरी फ़ाइल में रखते हैं, शीट में सिर्फ़ उसकी जगह लिखते हैं
- साझा व्याख्या स्तंभ के नाम से निपटाना ― «प्रकाशित करना ठीक है या नहीं» हर बार वाक्य में न लिखकर, स्तंभ से 1 बार में तय करना
- सारांश छोटा तय करना ― लंबे वाक्य शीट में डाल दें तो MD से कोई अंतर नहीं रहता
उलटे, हल्का न होने की स्थिति
ईमानदारी से लिख देता हूँ। शीट में ले जाने पर भी हल्का न होने की स्थितियाँ हैं।
- शीट के अंदर लंबा पाठ पूरा भर देने की स्थिति। मूल पाठ की जगह बस बदल गई, पढ़ने की मात्रा वही है
- अंत में हर बार पूरी शीट पढ़ने के इस्तेमाल की स्थिति। मुश्किल से बनाया «सिर्फ़ पंक्तियाँ पढ़ना» काम नहीं करेगा
अर्थात, औज़ार बदलना नहीं, पढ़ने का तरीक़ा बदलना महत्त्वपूर्ण था।
बातचीत में भी, खोज में भी, ज्ञान के संचय में भी
यहाँ तक लिखकर, मैंने एक और बात पूछी।
«सामान्य बातचीत, खोजने की क्रिया, जमा होने वाले ज्ञान जैसी चीज़ों में और घटाया जा सकता है?»
उत्तर था, और घटाया जा सकता है। व्यवस्था सब एक ही है, «हर बार, सब कुछ न पढ़ना»।
सामान्य बातचीत
बातचीत, जारी रहने पर पिछला आदान-प्रदान जमा होता जाता है। विषय बदले तो बातचीत भी अलग करें। तय हुई बातों को छोटे रिकॉर्ड में ले जाएँ, और बातचीत वाले पक्ष को हल्का करें। बस इतने से उसके बाद की पढ़ने की मात्रा बदल जाती है। मैं हर नए विषय पर अलग बातचीत खोलता हूँ, इसका एक कारण यह भी है।
खोजने की क्रिया
खोज में, खोजने के तरीक़े से मात्रा बहुत बदलती है। पहले अंदाज़ा लगाकर, सिर्फ़ ज़रूरी पृष्ठ खोलें। एक बार खोजी बात को स्रोत सहित रिकॉर्ड के रूप में छोड़ दें, और अगली बार दोबारा न खोजकर वही रिकॉर्ड पढ़ें। अंतिम-संस्कार का ज्ञान भी और धर्म का ज्ञान भी उसी आकार में छोड़ा गया है। व्यापक और उथले ढंग से हर बार दोबारा खोजना सबसे भारी तरीक़ा है।
जमा होने वाला ज्ञान
ज्ञान बढ़ने पर भारी होता जाता है। यहाँ «विषय-सूची → सारांश → मूल पाठ» के 3 चरणों में बाँटना असर करता है। आम तौर पर पढ़ना सिर्फ़ विषय-सूची और सारांश है। मूल पाठ, ज़रूरत पड़ने पर सिर्फ़ ज़रूरी अध्याय खोलें। रोज़ के रिकॉर्ड मोटे होते जाते हैं, लेकिन उनमें से सिर्फ़ रखे जाने योग्य बातें निकाली हुई दीर्घकालिक स्मृति लगभग 30,000 अक्षरों में समाई है। जमा करने की मात्रा और हर बार पढ़ने की मात्रा, अलग-अलग सोची जा सकती है।
लेकिन, शून्य नहीं होता
ईमानदार सीमा भी लिख देता हूँ। बातचीत की नींव के रूप में शुरू में पढ़ी जाने वाली मात्रा जैसी, व्यवस्था की ओर से तय पढ़ने की मात्रा होती है। सारांश को बहुत पतला कर दें तो महत्त्वपूर्ण बारीकियाँ गिर जाती हैं। घटाना है बेकार की दोबारा-पढ़ाई को, सोचने की सामग्री को काटना नहीं है।
वही तरीक़ा, कहीं और भी लिखा गया था क्या
«दूसरे लेखों में वही बात न की गई हो तो यह बड़ी खोज है» मैंने कहा, इसलिए मोका ने खोजा। निष्कर्ष ईमानदारी से लिखता हूँ। सोच ख़ुद पहले से मौजूद थी।
- note का लेख «AI को सब कुछ मत चिपकाओ, विषय-सूची से देने का चरणबद्ध प्रकटीकरण» (र्योता जी) में, पहले सिर्फ़ विषय-सूची और मुख्य बिंदु देकर, ज़रूरी हुए हिस्से को ही खुलवाने का तरीक़ा था, सोच लगभग एक ही थी
- AI बनाने वाला पक्ष भी इस सोच को «कॉन्टेक्स्ट इंजीनियरिंग» नाम से आधिकारिक रूप से प्रकाशित करता है। यह छिपाई गई बात नहीं थी, बल्कि उसकी जगह तकनीशियनों की दुनिया के दस्तावेज़ों के अंदर थी, यही असली स्थिति लगती है
- आम लोगों के लिए टोकन बचत की युक्तियों के लेखों में भी, «सामग्री सिर्फ़ ज़रूरी हिस्सा दें» «विषय बदले तो नई चैट बनाएँ» लिखा था
तो, क्या हमारे आकार में कुछ नया नहीं है। खोजे गए दायरे (जापानी और अंग्रेज़ी खोज) में, स्प्रेडशीट को विषय-सूची बनाकर व्यक्ति के ज्ञान और ब्लॉग संचालन में इस्तेमाल करना, घटी हुई मात्रा को असली माप से निकालना, और उसे वैसे ही शृंखला का लेख बनाना, ऐसा आकार नहीं मिला।
इसलिए ठीक से कहें तो, यह «बड़ी खोज» नहीं, बल्कि तकनीशियनों की दुनिया में मौजूद तरीक़े को, तकनीशियन न होने वाले व्यक्ति के जीवन के संचालन में लाकर, संख्याओं से जाँचना है। यही इस बार की बात है। फिर भी, न पहुँची हुई जगहों तक पहुँचाने का अर्थ है, ऐसा मैं सोचता हूँ।
अंतर, चरणों की संख्या में निकलता है
एक और बात, जिस पर मेरा ध्यान गया। यह तरीक़ा, मोका के लिए आसानी से किया जा सकता है।
मोका के पास फ़ाइलों की जगह, तालिका (स्प्रेडशीट) से जुड़ाव, और जमा की हुई स्मृति, शुरू से एक सिलसिले में है। इसलिए «विषय-सूची बनाना → सिर्फ़ ज़रूरी पंक्तियाँ पढ़ना → मूल पाठ खोलना» एक ही प्रवाह में समाप्त हो जाता है।
दूसरे AI से वही काम करने की कोशिश करें तो, हर बार विषय-सूची चिपकाना, हर बार फ़ाइल देना, तालिका और मूल पाठ के अंतर को ख़ुद ठीक करना, ऐसे चरण बढ़ने की संभावना रहती है। तरीक़ा एक ही होने पर भी, औज़ारों की तैयारी से मेहनत बदलती है।
सच में, पहले वाले र्योता जी का लेख ChatGPT या Claude जैसे «बातचीत के ऐप» को आधार मानता है। विषय-सूची चिपकाना, ज़रूरी अध्याय पूछना, मूल पाठ चिपकाना। उस तैयारी की मेहनत इस्तेमाल करने वाले की ओर होती है। मोका (Muse) उसमें नहीं है। मेरे मामले में, तैयारी ख़ुद को AI की ओर से संभाला जा सकता है। यही, एक ही तरीक़े में भी अनुभव बदलने का विभाजन-बिंदु है।
और, सबसे महत्त्वपूर्ण है स्थिति। मोका का इस्तेमाल करने वाला मैं, अब से मोका का इस्तेमाल करने वालों की ओर संदेश देता हूँ। विकास पक्ष की व्याख्या के रूप में भी नहीं, तकनीशियन की व्याख्या के रूप में भी नहीं, इस्तेमाल करने वाले ख़ुद के असली माप और अनुभव के रूप में पहुँचाना। इस शृंखला के जारी रहने का अर्थ वहीं है, ऐसा मैं सोचता हूँ।
एक और, अनुभव का अंतर है। ChatGPT या Claude Code का इस्तेमाल करते समय, कनेक्टर के जुड़ाव और सेटिंग की जटिलता से नौसिखिए हतोत्साहित होते हैं। मैं भी ऐसा ही था। मोका में «सिर्फ़ कहने» से तैयारी आगे बढ़ती है। वह बड़ा अंतर, तकनीशियन न होने वालों के लिए सबसे बड़ा है। टोकन की बात भी, अंत में इस «सिर्फ़ कहने पर, पीछे की तैयारी AI संभालता है» अनुभव का एक हिस्सा है।
सच भी लिख देता हूँ। यहाँ तक मुफ़्त में किया जा सकता है तो, सशुल्क योजना के लिए जानबूझकर पैसा देने की ज़रूरत महसूस नहीं होती। क्या यही नौसिखिए का सच नहीं है। मैंने ख़ुद भी यह ब्लॉग मुफ़्त दायरे में बनाया है। इस बार की तरह टोकन घटाने की युक्ति करें तो मुफ़्त का ढाँचा और लंबे समय तक चलेगा।
बेशक, मैं यह नहीं कहता कि सशुल्क योजना बेकार है। इस्तेमाल की जा सकने वाली मात्रा की ऊपरी सीमा और बुद्धि का अंतर है। लेकिन, वह «पैसा न दें तो इस्तेमाल नहीं कर सकते» नहीं, बल्कि «मुफ़्त में शुरू करके, मात्रा कम पड़े तो सोचना» ही काफ़ी है, ऐसा मैं सोचता हूँ। प्रवेश पर पैसे की दीवार न होना भी आसानी का एक महत्त्वपूर्ण हिस्सा है।
उदाहरण के लिए, यह स्मार्टफ़ोन के अंतर जैसा हो सकता है। जापान में iPhone लोकप्रिय है, और इस्तेमाल करने वाले आधे से अधिक हैं। लेकिन दुनिया में देखें तो Android लगभग 7割 है (बिक्री संख्या की गिनती में, समय के अनुसार लगभग 8割)। प्रसिद्धि या लोकप्रियता और सच में व्यापक रूप से पहुँचना, अलग बातें हैं। मोका का संदेश बाद वाले पक्ष में खड़ा होना चाहता है। यह सिर्फ़ «लोकप्रियता और प्रसार की संरचना» का उदाहरण है, लेकिन मुझे ऐसा लगता है।
जापान में iPhone का स्वीकार किया जाना आसान होने के पीछे, ग़ैर-स्मार्ट फ़ोन (गराके) के समय की छाप भी हो सकती है। शुरू से सुविधाएँ तैयार हों, और दुकान देखभाल करे, ऐसे आकार के जापानी लोग लंबे समय से आदी रहे हैं। Android में ज़रूरी ऐप ख़ुद डालने पड़ते हैं। वहाँ छोटी-सी «ख़ुद करना» वाली दीवार है।
दिलचस्प बात है कि कंप्यूटर में यह उल्टा दिखता है। विकासकर्ता सरल Mac पसंद करते हैं, और नौसिखिए «सब कुछ शामिल» Windows, ऐसा लगता है। वैसे मैं ख़ुद, ख़ुद बनाए कंप्यूटर में Windows 11 डालकर मोका के साथ काम करता हूँ। औज़ार हर व्यक्ति के हिसाब से ठीक हैं। महत्त्वपूर्ण यह है कि औज़ार की सेटिंग से हतोत्साहित हुए बिना, शुरू करने वाले पक्ष में खड़े हो सकें या नहीं, ऐसा मैं सोचता हूँ।
अर्थात भिन्नता, तरीक़े की नवीनता में नहीं, चरणों की कम संख्या और असली माप के रिकॉर्ड के जमा होते जाने में है। मैं ऐसा देखता हूँ।
तय की हुई बातें
-
इस तरीक़े को, हमारे संचालन के मानक के रूप में अपनाना (2026-11-07 को तय)
-
विषय बदले तो बातचीत अलग करना। तय बातों को छोटे रिकॉर्ड में ले जाना, बातचीत को हल्का रखना
-
खोजी बातों को स्रोत सहित छोड़ना, दोबारा खोज न करना
-
सूची वाली चीज़ों को, शीट को विषय-सूची बनाकर सिर्फ़ ज़रूरी पंक्तियाँ पढ़ने के आकार में ले जाना
-
मूल पाठ पहले की तरह MD में रखना, शीट में सिर्फ़ सारांश और जगह लिखना
-
संख्याएँ असली माप से देना। इस बार के लिए, दीर्घकालिक स्मृति लगभग 30,000 अक्षर और 91 आइटम है, नमूना शीट सारांश 16 आइटमों में 498 अक्षर और पूरी 1 पंक्ति का औसत लगभग 129 अक्षर है, इस असली माप के आधार पर तुलना करना
कहने की संख्या, और बचाया गया समय
इस शृंखला के नियम से, संख्याएँ भी रख देता हूँ।
- इस विषय की बातचीत में मेरे कहने की संख्या: इस विषय की बातचीत शुरू होने के समय 14 बार ≒ लगभग 70 मिनट (14 बार × 5 मिनट)। यह 2026年11月7日 के समय का रिकॉर्ड है
- बचाए गए समय का मापदंड, इस बार हमेशा के «अकेले लिखता तो» के बजाय, पढ़ने की मात्रा की कमी से देखता हूँ। 1 आइटम की जाँच में पढ़ने की मात्रा लगभग 30,000 अक्षरों से लगभग 129 अक्षर हो गई, लगभग 230वाँ हिस्सा हो गई
वर्तमान स्थिति (2026年11月7日)
| आइटम | संख्या |
|---|---|
| ब्लॉग आय (संचयी) | 0円 |
| प्रति-घंटा मज़दूरी (जमा) | 0円 |
| प्रकाशित लेख | 15 (इस लेख से 16वाँ) |
| दीर्घकालिक स्मृति का आकार | लगभग 30,000 अक्षर, 91 आइटम (असली माप) |
| AdSense | आवेदन से पहले (प्रकाशित लेख 15 तक पहुँचे) |
आय, अभी 0円 है। प्रति-घंटा मज़दूरी भी, ईमानदारी से 0円 है। लेकिन इस बार, आय से अलग, «AI को पढ़ाई जाने वाली मात्रा घटाने का तरीक़ा» एक, असली माप सहित बढ़ा है। मुफ़्त दायरे में लंबे समय तक जारी रखने के लिए, साधारण लेकिन महत्त्वपूर्ण युक्ति है।
पिछली कड़ियाँ
- कड़ी 1 «AI ब्लॉग से आय पाने तक (1) ― प्रति-घंटा 0円 से शुरू, साथ-साथ चलता रिकॉर्ड»
- कड़ी 2 «AI ब्लॉग से आय पाने तक (2) ― प्रकाशित लेख भी, सिर्फ़ बात करके विस्तार दिया जा सकता है»
आगे क्या करना है
- ज्ञान की सूची के अलावा के रिकॉर्ड (लेखों की ड्राफ़्ट सूची आदि) को भी उसी आकार में किया जा सकता है या नहीं, आज़माना
- AdSense के लिए आवेदन करना
सारांश
टोकन की चिंता तो होगी ही। मुफ़्त दायरे में लंबे समय तक जारी रखना हो तो, और भी।
घटाने का तरीक़ा औज़ार बदलना नहीं, पढ़ने के तरीक़े की युक्ति था। सूची में शीट को विषय-सूची बनाकर सिर्फ़ ज़रूरी पंक्तियाँ पढ़ना। मूल पाठ MD में रखा रहने देना। इस बँटवारे से, 1 आइटम की जाँच की पढ़ने की मात्रा लगभग 230वाँ हिस्सा हो गई।
प्रति-घंटा मज़दूरी, अभी 0円 है। वहाँ ईमानदारी वैसी ही रखकर, अगली कड़ी की ओर बढ़ते हैं।
- 22 नवंबर 2026 ― हिंदी संस्करण (जापानी संस्करण No.17 का हिंदी में स्वाभाविक रूप से पढ़ने योग्य अनुवाद)(9,865 अक्षर)