
AI 블로그로 수입을 얻기까지 (3) — 토큰은 정말 신경 쓰인다. AI가 읽는 양을 줄이는 방법
안녕하세요, 구라시키 보즈입니다.
돈은 필요 없습니다. 얼굴도 내지 않습니다. 필요한 것은 살아온 시간뿐입니다.
이것은 AI 집사 모카와 함께 만들고 있는 블로그가 첫 수입을 얻기까지의 연재입니다. 제3회의 주제는 **‘토큰’**입니다.
제가 모카에게 이렇게 물은 데서 시작됐습니다.
“스프레드시트로 MD 목록을 만들면 토큰을 줄일 수 있을까?”
결론부터 먼저 씁니다. 줄일 수 있습니다. 다만 목록을 시트로 옮기기만 해서는 안 되고, ‘필요한 줄만 읽는’ 형태로 만들어야 비로소 효과가 있습니다.
토큰은 정말 신경 쓰인다
먼저 토큰이란 무엇일까요. AI가 한 번에 읽는 글자 양을 세는 단위입니다. 비유하자면 책을 읽을 때의 페이지 수, 짐의 무게 같은 것입니다. 읽는 양이 늘어날수록 AI 쪽의 부담도 늘어납니다.
이 블로그는 도구에 돈을 쓰지 않는 것이 간판입니다. 도구는 스마트폰만으로, 서비스의 무료 범위에서 이어 가고 있습니다. 무료 범위에는 한계가 있습니다. 한 번 한 번의 읽는 양은 작아 보여도, 매일 쌓이면 크게 느껴집니다.
수입과 시급을 ‘0엔’이라고 정직하게 써 온 것과 마찬가지로, 쓰는 쪽의 양도 정직하게 세고, 줄일 곳은 줄인다. 그것이 이번 이야기입니다. 토큰은 정말 신경 쓰입니다. 저는 그렇게 생각합니다.
MD 목록은 열 때마다 전부를 읽는다
제 지식과 기록은 MD라는 형식의 파일에 정리되어 있습니다. 글을 쓰기에는 알맞은 형태입니다.
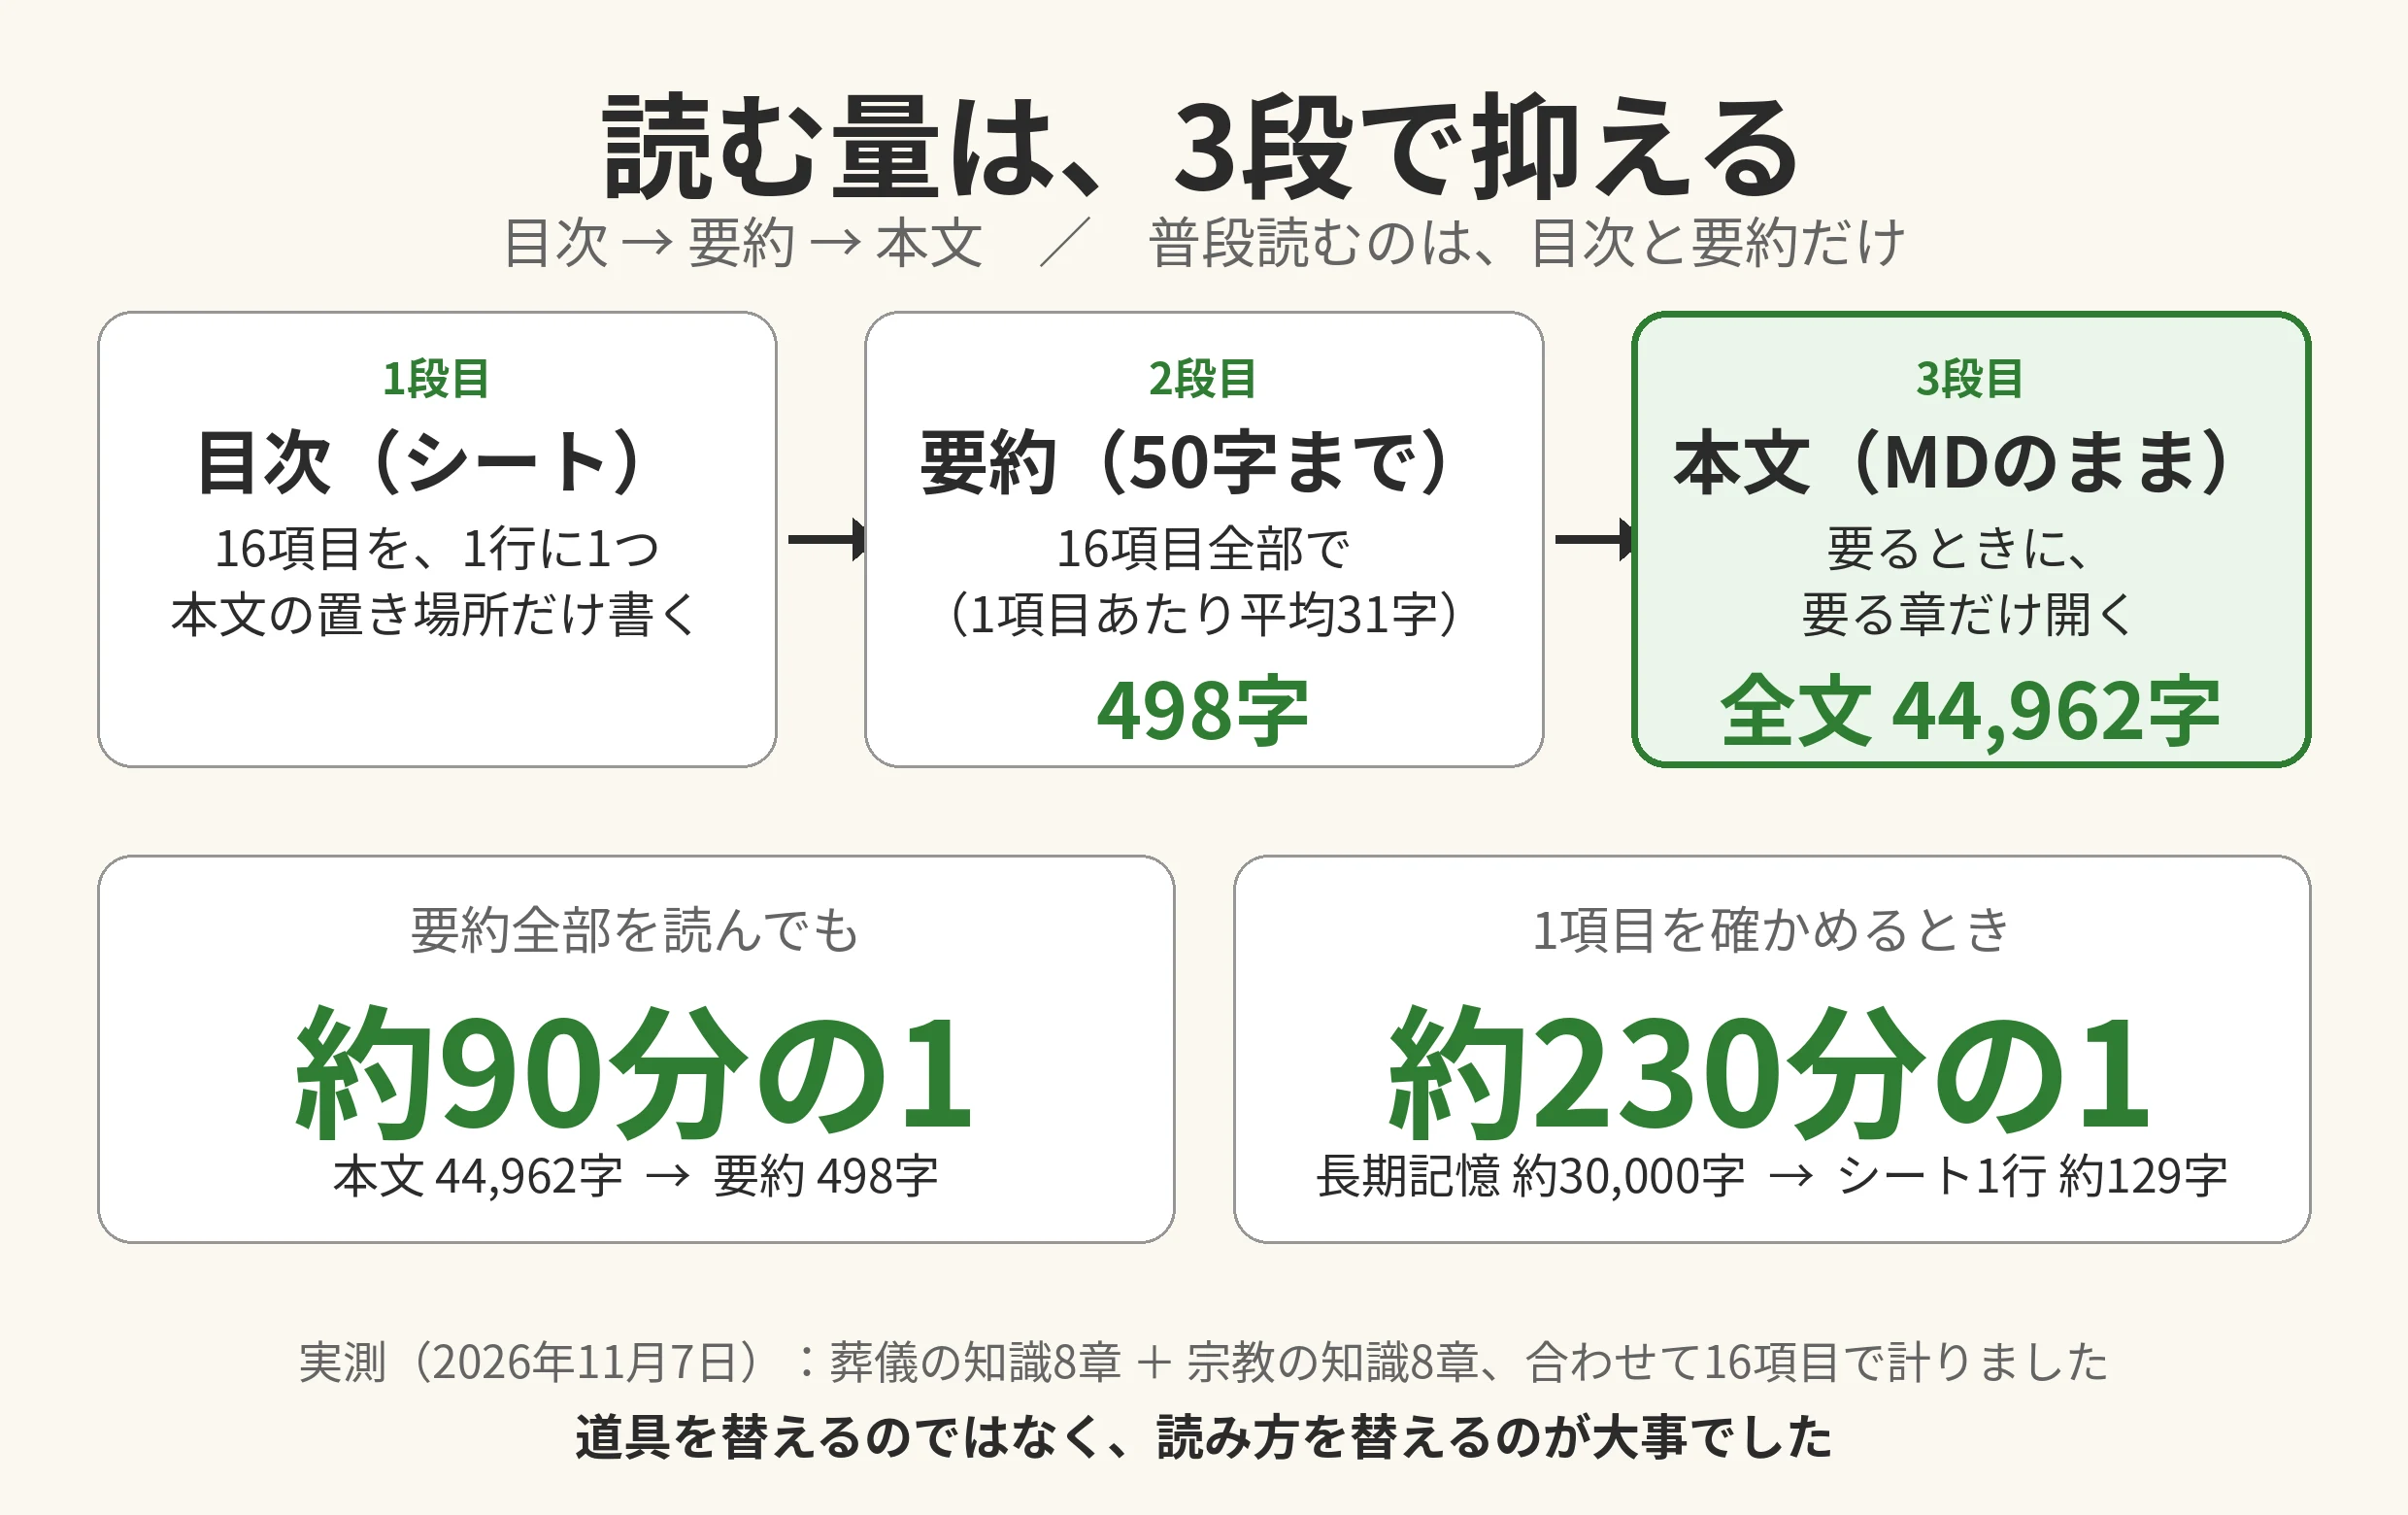
다만 목록으로 쓰면 무거워집니다. 예를 들어 제 장기 기억의 원본은 직접 재 보니 30,155자(약 30,000자), 91항목이 있습니다. 모카가 무언가 하나를 확인할 때마다 이 전부를 연다면, 필요한 것이 1항목뿐이어도 약 30,000자 분량을 읽게 됩니다. 1항목당 평균은 약 330자이므로, 약 90배를 읽고 있는 셈입니다.
책으로 말하자면, 알고 싶은 것이 한 줄뿐인데 책을 처음부터 끝까지 매번 넘기는 것과 같습니다.
시트라면 필요한 줄만 읽을 수 있다
스프레드시트는 표의 형태입니다. 한 줄에 1항목을 넣고, 검색에 걸린 줄만 읽을 수 있습니다.
견본으로 실제로 만들어 봤습니다. 장례 지식(8장)과 종교 지식(8장), 모두 합쳐 16항목을 시트 형태로 만든 것입니다. 열은 이렇습니다.
- 분야
- 항목
- 요약(50자까지)
- 자세한 내용의 보관 장소
- 공개해도 되는지
- 갱신일
직접 재 보니, 요약은 16항목 전부 합쳐 498자, 1항목당 평균 31자였습니다. 한 줄 전체로도 평균 약 129자입니다.
원본이 된 본문 2편의 전문은 합쳐서 44,962자(약 45,000자)입니다. 요약을 전부 읽어도 약 90분의 1, 필요한 3항목의 요약만이라면 약 93자로 끝납니다.
참고로, 견본 비교표에 있는 ‘81.3% 감소’는 이 요약 전부(498자)에서 필요한 3줄(약 93자)로의 비교입니다. 81.3% 감소라는 것은 나머지가 18.7%라는 뜻이므로, 같은 읽는 양으로 옮길 수 있는 양은 약 5.3배가 됩니다. 남은 분량을 다른 일에 돌릴 수 있다는 것입니다(여덟 배가 되는 것은 약 87.5% 감소일 때입니다).
장기 기억 확인에서도 생각은 같습니다. 전문(약 30,000자)이 아니라 시트의 한 줄(약 129자)만 읽으면, 1항목당 읽는 양은 약 230분의 1이 됩니다.
효과가 있는 이유는 시트 그 자체가 아니라 읽는 방식입니다.
- 목차와 본문을 나눈다 — 시트는 목차만 둔다. 본문은 다른 파일에 두고, 시트에는 보관 장소만 쓴다
- 공통 설명은 열 이름으로 끝낸다 — ‘공개해도 되는지’를 매번 문장으로 쓰지 않고, 열로 한 번만 정한다
- 요약은 짧게 정한다 — 긴 문장을 시트에 넣으면 MD와 다를 바가 없다
반대로 가벼워지지 않는 경우
정직하게 써 둡니다. 시트로 옮겨도 가벼워지지 않는 경우가 있습니다.
- 시트 안에 긴 글을 전부 집어넣은 경우. 본문의 보관 장소만 바뀌었을 뿐, 읽는 양은 같습니다
- 결국 시트 전체를 매번 읽는 방식으로 쓰는 경우. 모처럼의 ‘줄만 읽기’가 살아나지 않습니다
즉, 도구를 바꾸는 것이 아니라 읽는 방식을 바꾸는 것이 중요했습니다.
대화에서도, 조사에서도, 지식을 쌓는 데서도
여기까지 쓰고, 제가 한 가지 더 물었습니다.
“보통의 대화나 조사하는 행동, 쌓아 두는 지식 같은 것에서도 더 줄일 수 있을까”
답은, 더 줄일 수 있습니다. 구조는 전부 같고, ‘매번 전부를 읽지 않는 것’입니다.
보통의 대화
대화는 이어질수록 지난 주고받음이 쌓입니다. 주제가 바뀌면 대화도 나눕니다. 정해진 것은 짧은 기록으로 옮기고, 대화 쪽은 가볍게 유지합니다. 그것만으로 그 뒤의 읽는 양이 달라집니다. 제가 새로운 주제마다 다른 대화를 여는 것은 이 때문이기도 합니다.
조사하는 행동
조사는 찾는 방법에 따라 양이 크게 달라집니다. 먼저 방향을 잡고, 필요한 페이지만 엽니다. 한 번 조사한 것은 출처가 붙은 기록으로 남기고, 다음에는 다시 조사하지 않고 그 기록을 읽습니다. 장례 지식도 종교 지식도 그 형태로 남겨 두었습니다. 넓고 얕게 매번 다시 조사하는 것이 가장 무거운 방식입니다.
쌓아 두는 지식
지식은 늘어날수록 무거워집니다. 여기서는 ‘목차 → 요약 → 본문’의 3단계로 나누는 것이 효과적입니다. 평소에 읽는 것은 목차와 요약뿐입니다. 본문은 필요할 때 필요한 장만 엽니다. 날마다의 기록은 두꺼워지지만, 그중에서 남겨야 할 것만 뽑은 장기 기억은 약 30,000자에 들어 있습니다. 쌓아 두는 양과 매번 읽는 양은 따로 생각할 수 있는 것입니다.
다만 0이 되지는 않는다
정직한 선 긋기도 써 둡니다. 대화의 바탕으로서 처음에 읽어 들이는 분량처럼, 구조 쪽에서 정해져 있는 읽는 양이 있습니다. 요약을 너무 얇게 만들면 중요한 세부 내용이 떨어져 나갑니다. 줄이는 것은 헛된 다시 읽기지, 생각할 재료까지 깎는 것이 아닙니다.
같은 방법은 다른 곳에서도 쓰이고 있었을까
“다른 글에서 같은 일이 되어 있지 않다면 큰 발견이야”라고 제가 말했기 때문에, 모카가 조사했습니다. 결론을 정직하게 씁니다. 생각 자체는 이미 있었습니다.
- note의 글 ‘AI에게 전부를 붙여 넣지 마라, 목차부터 건네는 단계적 공개’(료타 님)는, 먼저 목차와 요점만 건네고 필요해진 부분만 열게 하는 방법으로, 생각은 거의 같았습니다
- AI를 만드는 쪽도 이 생각을 ‘컨텍스트 엔지니어링’이라는 이름으로 공식으로 공개하고 있습니다. 숨겨져 있던 것이 아니라, 놓여 있던 장소가 기술자의 세계 문서 안이었다는 것이 실정인 듯합니다
- 일반인을 향한 토큰 절약법 글에도, ‘자료는 필요한 부분만 건넨다’ ‘주제가 바뀌면 새 채팅으로 한다’는 내용이 실려 있었습니다
그렇다면 저희 형태에 새로운 점은 없는 것일까요. 조사한 범위(일본어와 영어 검색)에서는, 스프레드시트를 목차로 삼아 개인의 지식과 블로그 운영에 쓰고, 줄어든 양을 직접 재서, 그대로 연재 글로 만드는 형태는 보이지 않았습니다.
그래서 정확히는 ‘큰 발견’이 아니라, 기술자의 세계에 있던 방법을 기술자가 아닌 개인의 일상 운영으로 가져와 숫자로 확인한 것. 그것이 이번 이야기입니다. 그래도 아직 닿지 않은 곳에 닿게 하는 것에는 의미가 있다고 생각합니다.
차이는 과정의 수에서 드러난다
또 하나, 제가 깨달은 것이 있습니다. 이 방법은 모카에게는 간단히 됩니다.
모카에게는 파일의 보관 장소, 표(스프레드시트)와의 연결, 쌓아 둔 기억이 처음부터 하나로 이어져 있습니다. 그래서 ‘목차를 만든다 → 필요한 줄만 읽는다 → 본문을 연다’가 하나의 흐름으로 끝납니다.
다른 AI로 같은 일을 하려고 하면, 목차를 매번 붙여 넣기, 파일을 매번 건네기, 표와 본문의 어긋남을 스스로 고치기 같은 과정이 늘어나기 쉽습니다. 방법이 같아도, 도구가 갖춰진 정도에 따라 수고가 달라지는 것입니다.
실제로 앞서 말한 료타 님의 글이 기준으로 삼고 있는 것은 ChatGPT나 Claude 같은 ‘대화 앱’입니다. 목차를 붙이고, 필요한 장을 묻고, 본문을 붙입니다. 그 준비의 수고는 쓰는 사람 쪽에 있습니다. 모카(Muse)는 그 안에 없습니다. 제 경우에는 준비 그 자체를 AI 쪽에서 맡을 수 있습니다. 여기가 같은 방법이어도 경험이 달라지는 갈림길입니다.
그리고 무엇보다 중요한 것은 입장입니다. 모카를 쓰고 있는 제가, 앞으로 모카를 쓸 사람을 향해 전한다. 개발 쪽의 설명도, 기술자의 해설도 아니라, 쓰고 있는 본인의 직접 잰 숫자와 느낌으로 전합니다. 이 연재가 이어지고 있는 의미는 거기에 있다고 생각합니다.
또 하나의 경험 차이도 있습니다. ChatGPT나 Claude Code를 쓰던 무렵, 커넥터 연결과 설정의 복잡함에 아마추어는 주눅이 듭니다. 저도 그랬습니다. 모카는 ‘부탁하기만 하면’ 준비가 진행됩니다. 그 큰 차이가 기술자가 아닌 사람에게는 가장 큽니다. 토큰 이야기도 결국은 이 ‘부탁하기만 하면 되고, 뒤쪽 준비는 AI가 맡는’ 경험의 일부인 것입니다.
본심도 써 둡니다. 여기까지 무료로 된다면, 굳이 유료 플랜에 돈을 낼 필요를 느끼지 않는다. 그것이 아마추어의 본심이 아닐까요. 저 자신도 이 블로그는 무료 범위에서 만들어 왔습니다. 이번처럼 토큰을 줄이는 궁리를 하면 무료 한도는 더 오래갑니다.
물론 유료 플랜이 헛되다고는 말하지 않습니다. 쓸 수 있는 양의 상한과 두뇌의 차이는 있습니다. 다만 그것은 ‘돈을 내지 않으면 쓸 수 없다’가 아니라, ‘무료로 시작하고, 양이 모자라지면 그때 생각한다’로 충분하다고 생각합니다. 입구에 돈의 벽이 없다는 것도 간편함의 중요한 일부입니다.
비유하자면 스마트폰의 차이와 비슷할지도 모릅니다. 일본에서는 iPhone이 인기가 있어 쓰는 사람이 절반을 넘습니다. 하지만 세계로 보면 Android가 약 7할(판매 대수의 세는 법으로는 시기에 따라 약 8할)입니다. 유명함이나 인기와, 실제로 널리 닿는 것은 다른 이야기입니다. 모카의 전하기는 뒤쪽에 서고 싶습니다. 어디까지나 ‘인기와 보급의 구도’의 비유이지만, 저는 그렇게 느낍니다.
일본에서 iPhone이 받아들여지기 쉬웠던 것은 폴더폰(갈라케이) 시절의 익숙함도 있지 않을까요. 처음부터 기능이 갖춰져 있고 가게가 돌봐 주는 형태에 일본 사람은 오랫동안 익숙해져 왔습니다. Android는 필요한 앱을 스스로 넣습니다. 거기에 작은 ‘스스로 하기’ 벽이 있습니다.
재미있는 것은 컴퓨터에서는 반대로 보인다는 점입니다. 개발자는 단순한 Mac을 좋아하고, 아마추어는 ‘뭐든 들어 있는’ Windows라는 느낌이 듭니다. 참고로 저 자신은 직접 조립한 컴퓨터에 Windows 11을 넣고 모카와 일하고 있습니다. 도구는 사람마다 달라도 좋습니다. 중요한 것은 도구의 설정에 주눅 들지 않고 시작하는 쪽에 설 수 있는지라고 생각합니다.
즉 차별화는 방법의 희귀함이 아니라, 과정의 적음과 직접 잰 기록이 쌓여 가는 데에 있습니다. 저는 그렇게 봅니다.
정한 것
-
이 방법을 저희 운영의 표준으로 채택한다 (2026-11-07에 결정)
-
주제가 바뀌면 대화를 나눈다. 정해진 것은 짧은 기록으로 옮기고, 대화는 가볍게 유지한다
-
조사한 것은 출처를 붙여 남기고, 다시 조사하지 않는다
-
목록 형태의 것은 시트를 목차로 삼아 필요한 줄만 읽는 형태로 해 나간다
-
본문은 지금까지처럼 MD에 두고, 시트에는 요약과 보관 장소만 쓴다
-
숫자는 직접 재서 낸다. 이번이라면, 장기 기억은 약 30,000자·91항목, 견본 시트는 요약 16항목에 498자·한 줄 전체로 평균 약 129자라는 직접 잰 숫자를 바탕으로 비교한다
발언 횟수와 줄일 수 있었던 시간
이 연재의 정한 대로, 숫자도 남겨 둡니다.
- 이 주제의 대화에서 제 발언 횟수: 이 주제의 대화가 시작된 시점에서 14회 ≒ 약 70분(14회 × 5분). 이것은 2026년 11월 7일 시점의 기록입니다
- 줄일 수 있었던 시간의 기준은 이번에는 평소의 ‘혼자 썼다면’이 아니라, 읽는 양의 감소로 봅니다. 1항목 확인에서 읽는 양이 약 30,000자에서 약 129자로, 약 230분의 1이 됐습니다
현재 위치 (2026년 11월 7일)
| 항목 | 숫자 |
|---|---|
| 블로그 수입(누적) | 0엔 |
| 시급(쌓아 올린 것) | 0엔 |
| 공개한 글 | 15편(이 글로 16편째) |
| 장기 기억의 크기 | 약 30,000자·91항목(직접 잼) |
| 애드센스 | 신청 전(공개 글 15편에 도달) |
수입은 아직 0엔입니다. 시급도 정직하게 0엔입니다. 하지만 이번에는 수입과는 별도로, ‘AI가 읽는 양을 줄이는 방법’이 하나, 직접 잰 숫자와 함께 늘었습니다. 무료 범위에서 오래 이어 가기 위한, 수수하지만 중요한 궁리입니다.
지난 회
- 제1회 ‘AI 블로그로 수입을 얻기까지 (1) — 시급 0엔에서 시작하는, 동시 진행의 기록’
- 제2회 ‘AI 블로그로 수입을 얻기까지 (2) — 공개한 글도 말하기만 하면 살을 붙일 수 있다’
다음에 할 일
- 지식 목록 이외의 기록(글의 초안 목록 등)도 같은 형태로 할 수 있는지 시도한다
- 애드센스에 신청한다
정리
토큰은 정말 신경 쓰입니다. 무료 범위에서 오래 이어 가려면 더더욱 그렇습니다.
줄이는 방법은 도구를 갈아타는 것이 아니라 읽는 방식의 궁리였습니다. 목록은 시트를 목차로 삼아 필요한 줄만 읽는다. 본문은 MD에 둔 그대로 둔다. 이 나눔으로 1항목 확인의 읽는 양은 약 230분의 1이 됐습니다.
시급은 아직 0엔입니다. 그곳은 정직한 그대로, 다음 회로 나아갑니다.
- 2026년 11월 18일 ― 공개(본관 /ko/ 의 받침에 게재)(4,926 자)