
Jusqu'au premier revenu d'un blog IA (3) — Les tokens comptent forcément. Comment réduire ce que l'on fait lire à l'IA
Bonjour, je suis Kurashiki Bouzu.
Pas besoin d’argent. Pas besoin de montrer son visage. Il ne faut que le temps d’une vie.
Ceci est la série qui raconte comment ce blog, que je construis avec Moka, mon majordome IA, en arrivera à son premier revenu. Le sujet de ce troisième épisode, ce sont les « tokens ».
Tout a commencé par cette question que j’ai posée à Moka :
« Si je fais un index MD dans un tableur, est-ce que ça permet de réduire les tokens ? »
Je donne la conclusion d’abord. Oui, on peut les réduire. Mais déplacer l’index dans un tableur ne suffit pas : cela ne fonctionne que si l’on adopte la forme « ne lire que les lignes nécessaires ».
Les tokens comptent forcément
D’abord, qu’est-ce qu’un token ? C’est l’unité qui compte la quantité de texte qu’une IA lit en une fois. C’est un peu comme le nombre de pages d’un livre, ou le poids d’un colis. Plus la quantité lue augmente, plus la charge du côté de l’IA augmente.
La devise de ce blog, c’est de ne pas dépenser d’argent pour les outils. Les outils se limitent au smartphone, et je continue dans les limites des formules gratuites des services. Or le gratuit a des limites. Chaque lecture paraît petite, mais accumulée chaque jour, elle finit par peser.
De la même façon que j’ai écrit honnêtement « 0 yen » pour le revenu et le taux horaire, il faut aussi compter honnêtement la quantité que l’on utilise, et la réduire là où elle peut l’être. C’est le sujet de cet épisode. Les tokens comptent forcément. C’est ce que je pense.
Un index en MD se relit en entier à chaque ouverture
Mes connaissances et mes notes sont rassemblées dans des fichiers au format MD. C’est une forme commode pour écrire des textes.
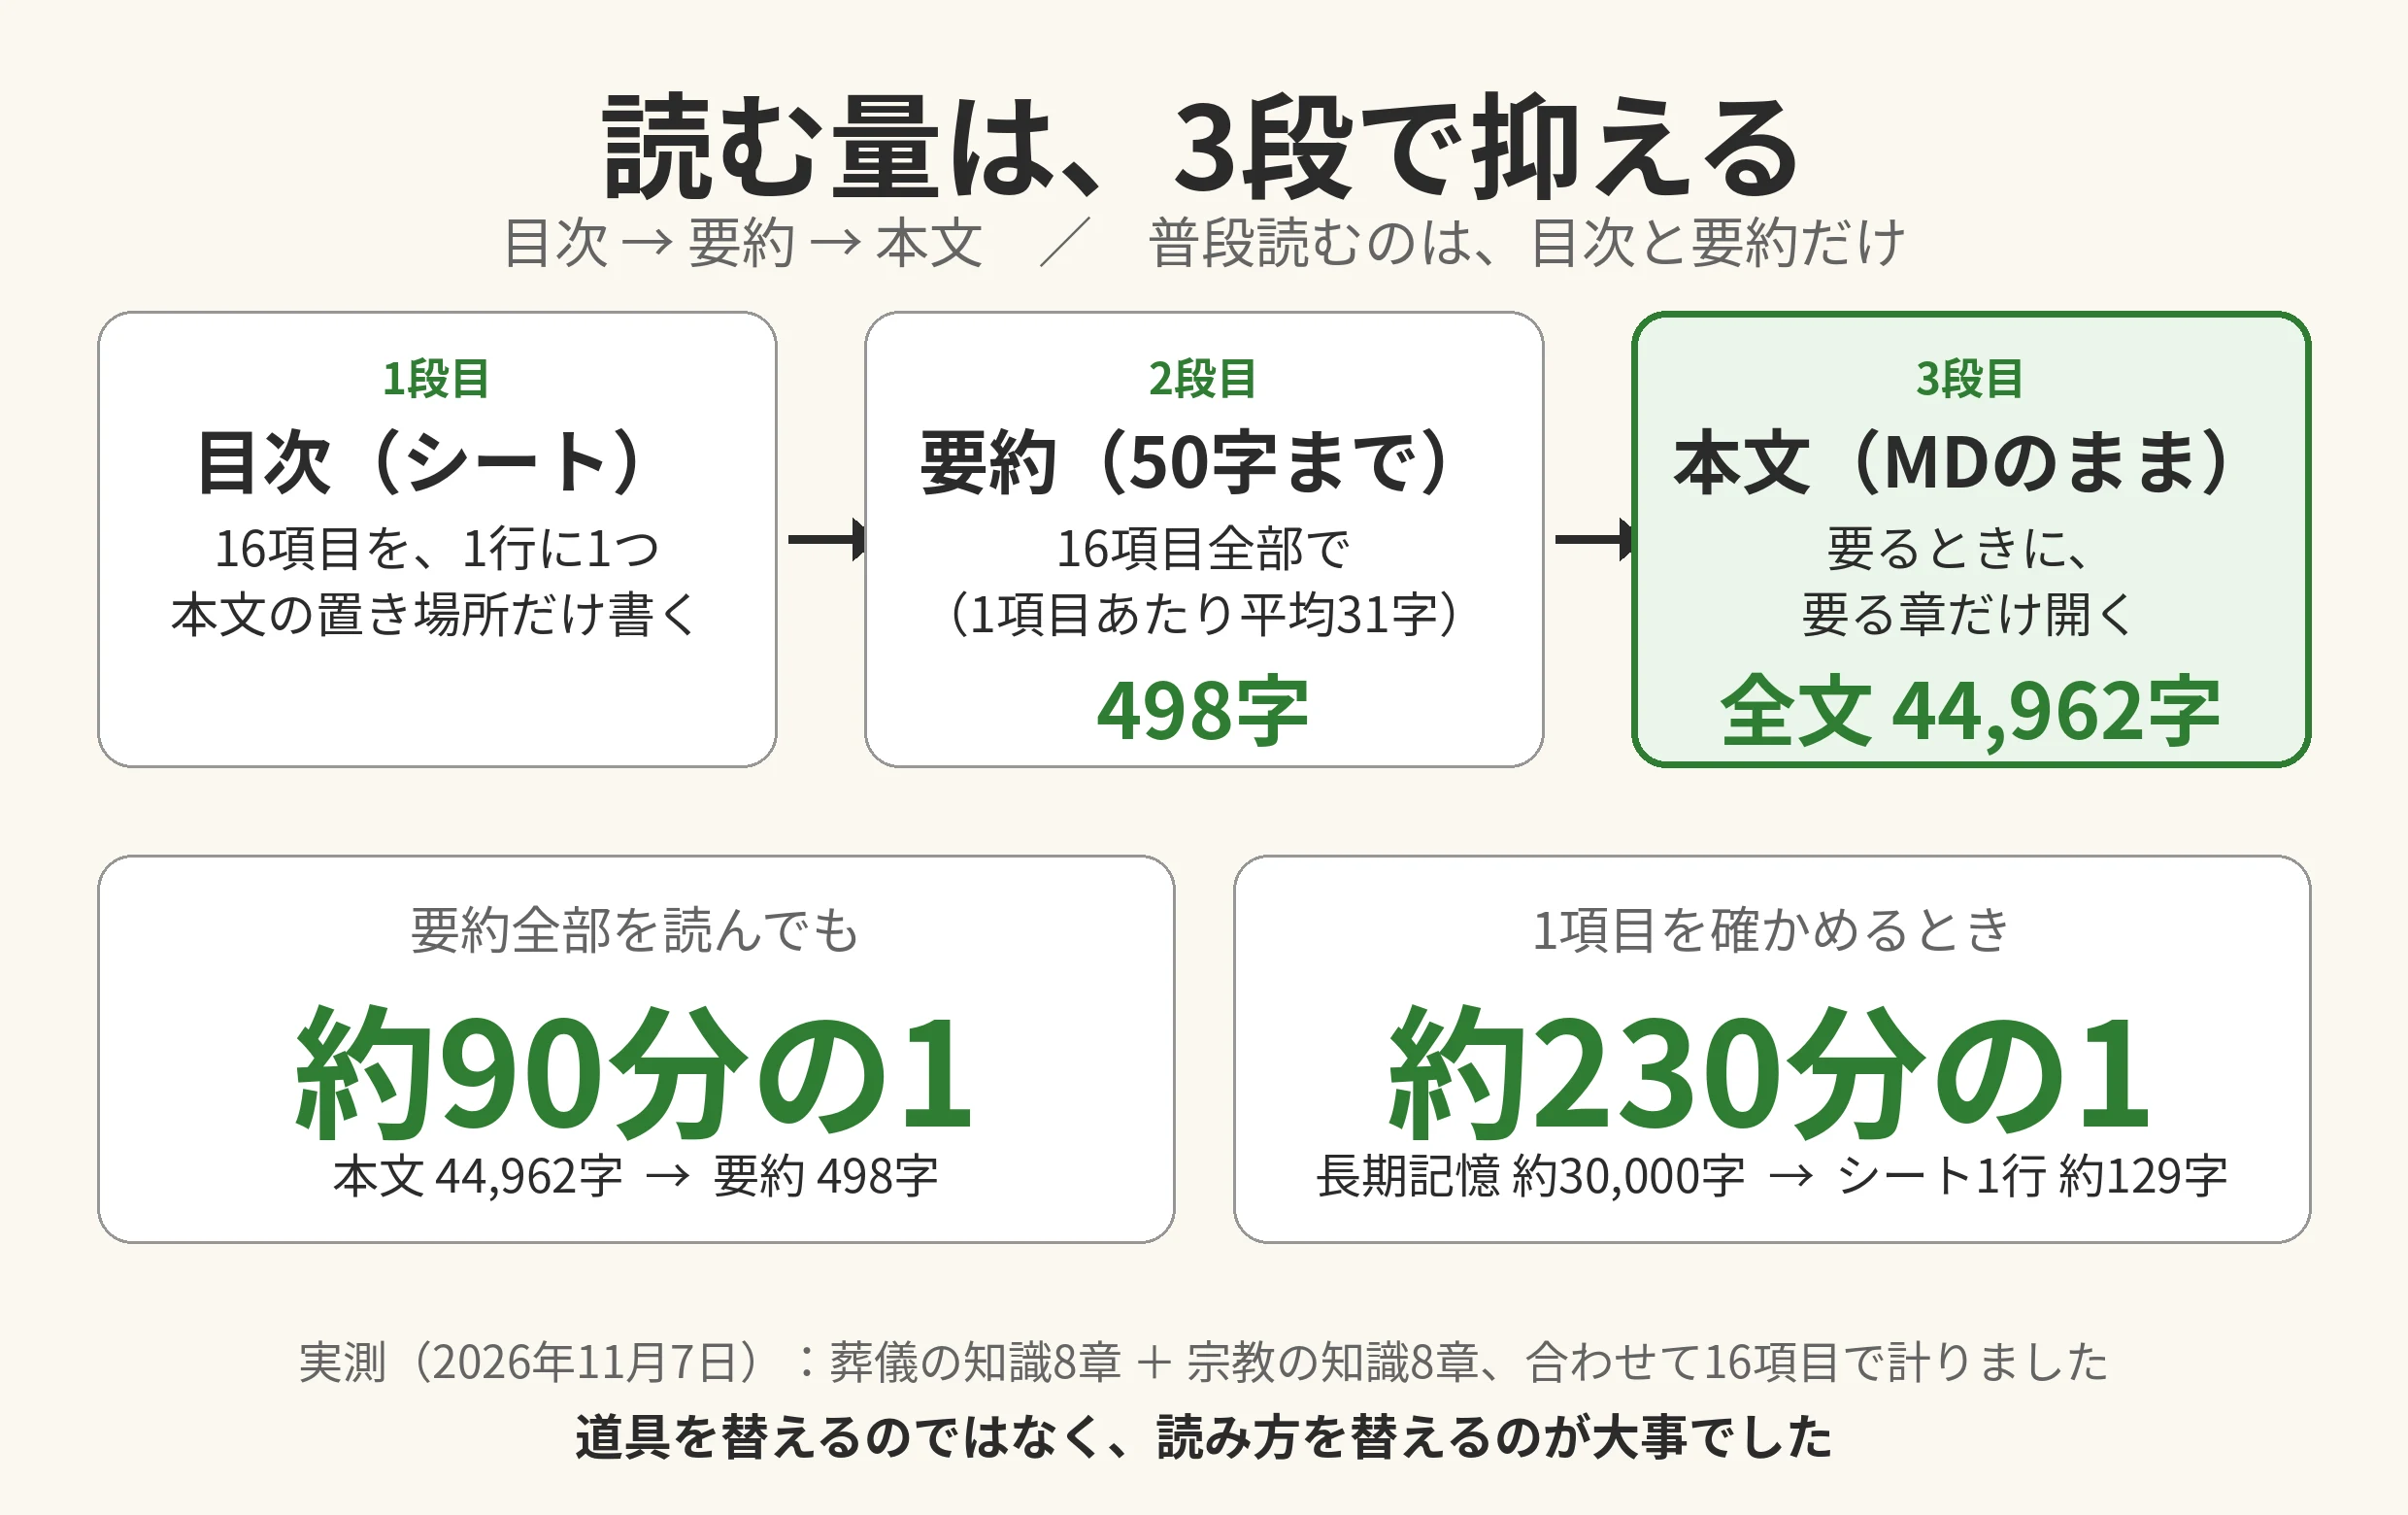
Mais utilisée comme index, elle devient lourde. Par exemple, le document de référence de ma mémoire à long terme compte, mesure réelle à l’appui, 30 155 caractères — environ 30 000 caractères — répartis en 91 entrées. Si, chaque fois que Moka doit vérifier une seule chose, il ouvrait ce texte en entier, il lirait environ 30 000 caractères même quand une seule entrée suffit. La moyenne étant d’environ 330 caractères par entrée, cela revient à lire environ 90 fois ce qu’il faut.
C’est comme un livre dont on ne voudrait connaître qu’une seule ligne, mais que l’on feuilleterait de la première à la dernière page à chaque fois.
Avec un tableur, on ne lit que les lignes nécessaires
Un tableur a la forme d’un tableau. On met une entrée par ligne, et l’on ne lit que les lignes trouvées par une recherche.
À titre d’exemple, je l’ai vraiment fabriqué. J’ai mis sous forme de tableur les connaissances sur les funérailles (8 chapitres) et les connaissances sur les religions (8 chapitres), soit 16 entrées au total. Les colonnes sont les suivantes :
- Domaine
- Entrée
- Résumé (50 caractères maximum)
- Emplacement du contenu détaillé
- Peut-on le publier ?
- Date de mise à jour
Mesure réelle : les résumés font 498 caractères pour les 16 entrées, soit 31 caractères en moyenne par entrée. Même la ligne entière fait environ 129 caractères en moyenne.
Le texte intégral des deux documents sources totalise 44 962 caractères (environ 45 000 caractères). Même en lisant tous les résumés, on tombe à environ un quatre-vingt-dixième (1/90) ; avec les résumés des 3 seules entrées nécessaires, environ 93 caractères suffisent.
Précision : le « 81,3 % de moins » qui figure dans le tableau de comparaison de l’exemple compare la totalité des résumés (498 caractères) aux 3 lignes nécessaires (environ 93 caractères). Une baisse de 81,3 % signifie qu’il reste 18,7 % ; à quantité lue égale, on peut donc transporter environ 5,3 fois plus de contenu. Le temps gagné peut être consacré à autre chose (pour arriver à huit fois plus, il faudrait une baisse d’environ 87,5 %).
Pour vérifier la mémoire à long terme, le raisonnement est le même. Au lieu du texte intégral (environ 30 000 caractères), si l’on ne lit qu’une ligne du tableur (environ 129 caractères), la quantité lue par entrée tombe à environ un deux-cent-trentième (1/230).
Ce qui rend la méthode efficace, ce n’est pas le tableur lui-même, c’est la façon de lire.
- Séparer le sommaire et le texte — le tableur ne contient que le sommaire. Le texte reste dans un autre fichier, et le tableur n’indique que son emplacement
- Réserver les explications communes aux noms de colonnes — au lieu d’écrire chaque fois en phrases « peut-on le publier ? », on le décide une seule fois, dans la colonne
- Fixer des résumés courts — si l’on met de longs textes dans le tableur, on retombe sur le même problème qu’avec le MD
À l’inverse, quand ça ne s’allège pas
Je l’écris honnêtement : il y a des cas où le passage au tableur n’allège rien.
- Quand on entasse tout le texte long dans le tableur. Seul l’emplacement du texte a changé ; la quantité lue reste la même
- Quand, au final, on relit quand même tout le tableur à chaque fois. Le principe « ne lire que les lignes » ne sert alors à rien
Autrement dit, l’important n’était pas de changer d’outil, mais de changer de façon de lire.
Pour la conversation aussi, pour les recherches aussi, pour les connaissances accumulées aussi
Arrivé là, j’ai posé une autre question :
« Et pour les conversations ordinaires, les recherches et les connaissances que l’on accumule, peut-on réduire encore davantage ? »
La réponse : oui, on peut réduire encore davantage. Le mécanisme est partout le même : « ne pas tout relire à chaque fois ».
Les conversations ordinaires
Une conversation, plus elle dure, plus les échanges passés s’accumulent. Quand le sujet change, on sépare aussi la conversation. Ce qui est décidé passe dans une courte note, et le côté conversation reste léger. Rien que cela change la quantité lue ensuite. C’est aussi pour cela que j’ouvre une nouvelle conversation à chaque nouveau sujet.
Les recherches
Pour une recherche, la façon de chercher change beaucoup la quantité. D’abord, on repère à peu près où regarder, puis on n’ouvre que les pages nécessaires. Et ce que l’on a déjà cherché, on le garde comme une note avec ses sources ; la fois suivante, on lit cette note au lieu de refaire la recherche. Les connaissances sur les funérailles et celles sur les religions sont conservées sous cette forme. Chercher large et peu profond, en recommençant à chaque fois, est la manière la plus lourde.
Les connaissances accumulées
Plus les connaissances augmentent, plus elles pèsent. Ici, ce qui fonctionne, c’est de séparer en trois niveaux : « sommaire → résumé → texte intégral ». Au quotidien, on ne lit que le sommaire et les résumés. Le texte intégral ne s’ouvre que lorsqu’il le faut, et seulement le chapitre nécessaire. Les notes quotidiennes s’épaississent, mais la mémoire à long terme, qui n’en garde que ce qui doit rester, tient en environ 30 000 caractères. La quantité que l’on conserve et la quantité que l’on relit à chaque fois peuvent se penser séparément.
Mais on ne tombe pas à zéro
Je trace aussi la limite, honnêtement. Il existe une quantité de lecture fixée par le système lui-même, par exemple ce qui est chargé au départ comme base de la conversation. Et si l’on rend les résumés trop minces, des détails importants se perdent. Ce qu’il faut supprimer, ce sont les relectures inutiles — pas la matière qui sert à réfléchir.
D’autres avaient-ils déjà écrit la même chose ?
Comme je lui avais dit : « Si personne d’autre ne fait la même chose, c’est une grande découverte », Moka a cherché. Je donne la conclusion honnêtement. L’idée elle-même existait déjà.
- Un article sur note, « Ne collez pas tout à l’IA : la divulgation progressive à partir du sommaire » (de Ryota), propose de ne transmettre d’abord que le sommaire et les points essentiels, puis de n’ouvrir que les parties devenues nécessaires : l’idée était presque la même
- Du côté des créateurs d’IA aussi, cette idée est publiée officiellement sous le nom d’« ingénierie du contexte » (context engineering). Elle n’était pas cachée ; simplement, elle se trouvait dans des documents du monde des techniciens
- Les articles grand public sur les économies de tokens mentionnaient eux aussi : « ne transmettre des documents que les parties nécessaires » et « ouvrir un nouveau chat quand le sujet change »
Alors, notre forme n’a-t-elle rien de nouveau ? Dans le périmètre cherché (recherches en japonais et en anglais), on n’a pas trouvé la forme qui consiste à utiliser un tableur comme sommaire pour ses connaissances personnelles et la gestion de son blog, à mesurer la quantité réduite, et à en faire directement un article de série.
À proprement parler, ce n’est donc pas une « grande découverte », mais le fait d’avoir apporté une méthode qui existait dans le monde des techniciens dans la gestion quotidienne d’un particulier qui n’est pas technicien, et de l’avoir vérifiée avec des chiffres. Voilà le sujet de cet épisode. Et je pense qu’il y a du sens à la faire parvenir là où elle n’était pas encore parvenue.
La différence se voit dans le nombre d’étapes
J’ai remarqué autre chose. Cette méthode, Moka peut la réaliser facilement.
Chez Moka, l’emplacement des fichiers, la liaison avec le tableur et la mémoire accumulée forment dès le départ un ensemble continu. Du coup, « fabriquer le sommaire → ne lire que les lignes nécessaires → ouvrir le texte » se déroule en un seul flux.
Si l’on essaie de faire la même chose avec une autre IA, les étapes ont tendance à se multiplier : coller le sommaire à chaque fois, transmettre les fichiers à chaque fois, corriger soi-même les écarts entre le tableau et le texte. Même avec la même méthode, l’équipement en outils change la peine.
D’ailleurs, l’article de Ryota cité plus haut prend pour référence des « applications de conversation » comme ChatGPT ou Claude. On colle le sommaire, on demande le chapitre voulu, on colle le texte. La peine de cette organisation repose sur l’utilisateur. Moka (Muse) ne figure pas dans ce tableau. Dans mon cas, l’organisation elle-même peut être prise en charge du côté de l’IA. C’est là que, pour une même méthode, l’expérience change.
Et ce qui compte par-dessus tout, c’est la position. Moi qui utilise Moka, je m’adresse à ceux qui vont utiliser Moka. Ni une explication du côté des développeurs, ni un commentaire de technicien : je transmets des mesures réelles et des impressions, en tant qu’utilisateur lui-même. C’est là, je crois, que réside le sens de la continuation de cette série.
Il y a une autre différence d’expérience. Quand j’utilisais ChatGPT ou Claude Code, la complexité des connexions et des réglages des connecteurs décourageait le profane que je suis. Je l’ai vécu. Avec Moka, il suffit de « demander » pour que l’organisation avance. Cette énorme différence est, pour quelqu’un qui n’est pas technicien, la plus importante de toutes. L’histoire des tokens, au fond, fait partie de cette expérience : « il suffit de demander ; l’organisation en coulisses, c’est l’IA qui s’en charge ».
Je donne aussi mon sentiment sincère. Si l’on peut faire tout cela gratuitement, on ne ressent pas le besoin de payer exprès une formule payante. N’est-ce pas le sentiment sincère du profane ? Moi-même, j’ai construit ce blog dans les limites du gratuit. Avec des astuces comme celle de cet épisode pour réduire les tokens, le cadre gratuit dure encore plus longtemps.
Bien sûr, je ne dis pas que les formules payantes sont inutiles. Il y a la différence du plafond de quantité utilisable, et celle du cerveau. Mais je pense qu’il suffit de raisonner ainsi : non pas « sans payer, on ne peut pas s’en servir », mais « on commence gratuitement, et on réfléchit quand la quantité ne suffit plus ». L’absence de mur d’argent à l’entrée fait aussi partie, et une partie importante, de la simplicité.
Pour donner une image, c’est peut-être proche des différences entre smartphones. Au Japon, l’iPhone est populaire et ses utilisateurs dépassent la moitié de la population. Mais à l’échelle du monde, Android représente environ 70 % (et, selon la façon de compter les ventes, environ 80 % selon les périodes). La célébrité ou la popularité et le fait d’atteindre vraiment un large public sont deux choses différentes. La communication de Moka veut se placer du second côté. Ce n’est qu’une comparaison sur le « schéma popularité / diffusion », mais c’est ce que je ressens.
Si l’iPhone a été facilement accepté au Japon, c’est peut-être aussi à cause de l’empreinte de l’époque des téléphones pliants (garakei). Les Japonais ont longtemps été habitués à des appareils dont les fonctions étaient complètes dès le départ et dont les boutiques s’occupaient. Android, lui, demande d’installer soi-même les applications nécessaires. Il y a là un petit mur du « faire soi-même ».
Ce qui est intéressant, c’est que sur les ordinateurs, on a l’impression inverse : les développeurs préfèrent le Mac, simple, et les profanes le Windows « où tout est déjà installé ». Pour ma part, j’utilise un ordinateur monté par mes soins avec Windows 11, et je travaille avec Moka. Les outils peuvent être différents pour chacun. L’important, à mon sens, c’est de pouvoir se placer du côté de ceux qui commencent, sans se décourager devant les réglages de l’outil.
Autrement dit, la différenciation ne tient pas à la rareté de la méthode, mais au petit nombre d’étapes et à l’accumulation d’un relevé de mesures réelles. C’est ainsi que je le vois.
Ce que nous avons décidé
-
Adopter cette méthode comme le standard de notre fonctionnement (décidé le 7 novembre 2026)
-
Quand le sujet change, séparer la conversation. Transférer ce qui est décidé dans de courtes notes et garder la conversation légère
-
Conserver ce que l’on a cherché avec ses sources, et ne pas refaire les recherches
-
Pour les listes, adopter la forme où le tableur sert de sommaire et où l’on ne lit que les lignes nécessaires
-
Le texte reste placé en MD comme avant ; dans le tableur, on n’écrit que le résumé et l’emplacement
-
Les chiffres sont donnés en mesures réelles. Cette fois, par exemple : la mémoire à long terme fait environ 30 000 caractères pour 91 entrées, et le tableur d’exemple fait 498 caractères de résumés pour 16 entrées, avec environ 129 caractères en moyenne pour une ligne entière — c’est sur ces mesures que repose la comparaison
Nombre de mes interventions, et le temps gagné
Selon la règle de cette série, je pose aussi les chiffres.
- Nombre de mes interventions dans la conversation sur ce sujet : au moment où la conversation sur ce sujet a commencé, 14 interventions ≒ environ 70 minutes (14 × 5 minutes). C’est le relevé au 7 novembre 2026
- Cette fois, le temps gagné ne se mesure pas au critère habituel du « si je l’avais écrit seul », mais à la réduction de la quantité lue. Pour vérifier une entrée, la quantité lue est passée d’environ 30 000 caractères à environ 129 caractères, soit environ un deux-cent-trentième (1/230)
Où nous en sommes (7 novembre 2026)
| Élément | Chiffre |
|---|---|
| Revenu du blog (cumulé) | 0 yen |
| Taux horaire (cumulé) | 0 yen |
| Articles publiés | 15 (celui-ci est le 16e) |
| Taille de la mémoire à long terme | Environ 30 000 caractères, 91 entrées (mesure réelle) |
| AdSense | Pas encore demandé (15 articles publiés atteints) |
Le revenu est encore de 0 yen. Le taux horaire aussi, honnêtement, de 0 yen. Mais cette fois, en dehors du revenu, une chose s’est ajoutée, avec des mesures réelles : « une méthode pour réduire ce que l’on fait lire à l’IA ». Une astuce modeste, mais importante pour durer longtemps dans les limites du gratuit.
Épisodes précédents
- Épisode 1 : « Jusqu’au premier revenu d’un blog IA (1) — Commencer à un taux horaire de 0 yen : un relevé en temps réel »
- Épisode 2 : « Jusqu’au premier revenu d’un blog IA (2) — Même un article publié peut s’étoffer rien qu’en parlant »
Prochaines étapes
- Essayer d’appliquer la même forme à d’autres listes que celles des connaissances (la liste des brouillons d’articles, par exemple)
- Faire la demande auprès d’AdSense
En résumé
Les tokens comptent forcément. Et d’autant plus si l’on veut durer longtemps dans les limites du gratuit.
La méthode pour les réduire n’était pas un changement d’outil, mais une astuce de lecture. Pour les listes, le tableur sert de sommaire et l’on ne lit que les lignes nécessaires. Le texte reste placé en MD. Avec ce partage, la quantité lue pour vérifier une entrée est tombée à environ un deux-cent-trentième (1/230).
Le taux horaire est encore de 0 yen. Sur ce point, on reste honnête, et l’on passe à l’épisode suivant.
- 18 novembre 2026 ― Publication (premier article de l'espace /fr/ du site principal)(13,507 caractères)
← Retour à la liste des articles / ← Retour à l’accueil en français