
Bis zum ersten Einkommen mit einem KI-Blog (3) — Token sind unvermeidlich ein Thema. Wie man die Menge klein hält, die man die KI lesen lässt
Guten Tag, ich bin Kurashiki Bouzu.
Kein Geld nötig. Kein Gesicht zeigen. Nötig ist nur die Zeit eines gelebten Lebens.
Dies ist die Reihe darüber, wie dieser Blog, den ich mit Moka, meinem KI-Butler, aufbaue, zu seinem ersten Einkommen kommt. Das Thema dieser dritten Folge sind die „Token“.
Alles begann mit dieser Frage, die ich Moka stellte:
„Kann man Token sparen, wenn man ein MD-Verzeichnis in einer Tabelle anlegt?“
Das Fazit vorweg. Ja, man kann sparen. Aber das Verzeichnis nur in eine Tabelle zu verschieben, reicht nicht — es wirkt erst, wenn man die Form „nur die nötigen Zeilen lesen“ daraus macht.
Token sind unvermeidlich ein Thema
Zuerst: Was ist ein Token? Es ist die Einheit, mit der man die Textmenge zählt, die eine KI auf einmal liest. Vergleichbar mit der Seitenzahl eines Buches oder dem Gewicht eines Pakets. Je mehr gelesen wird, desto größer wird die Last auf Seiten der KI.
Das Aushängeschild dieses Blogs ist, kein Geld für Werkzeuge auszugeben. Die Werkzeuge beschränken sich auf das Smartphone, und ich mache im kostenlosen Rahmen der Dienste weiter. Der kostenlose Rahmen hat Grenzen. Jede einzelne Lesemenge wirkt klein, aber Tag für Tag aufaddiert, macht sie sich bemerkbar.
Genauso wie ich beim Einkommen und beim Stundenlohn ehrlich „0 Yen“ geschrieben habe, gilt: Auch die Menge, die man selbst verbraucht, ehrlich zählen und dort sparen, wo es geht. Darum geht es in dieser Folge. Token sind unvermeidlich ein Thema. So sehe ich es.
Ein MD-Verzeichnis wird bei jedem Öffnen vollständig gelesen
Mein Wissen und meine Aufzeichnungen sind in Dateien im MD-Format gesammelt. Zum Schreiben von Texten ist das eine bequeme Form.
Als Verzeichnis genutzt, wird sie jedoch schwer. Das StammDokument meines Langzeitgedächtnisses zum Beispiel umfasst nach echter Messung 30.155 Zeichen — rund 30.000 Zeichen — in 91 Einträgen. Würde Moka jedes Mal, wenn nur eine Sache zu prüfen ist, diesen Volltext öffnen, läse er rund 30.000 Zeichen, selbst wenn nur ein Eintrag nötig wäre. Der Durchschnitt liegt bei rund 330 Zeichen pro Eintrag, also liest man rechnerisch das rund 90-Fache des Nötigen.
Das ist wie bei einem Buch, von dem man nur eine einzige Zeile wissen will, das man aber jedes Mal von der ersten bis zur letzten Seite durchblättert.
Mit einer Tabelle liest man nur die nötigen Zeilen
Eine Tabelle hat die Form einer Liste. Man legt einen Eintrag pro Zeile an und kann nur die Zeilen lesen, die eine Suche trifft.
Als Beispiel habe ich es wirklich gebaut. Das Wissen über Bestattungen (8 Kapitel) und das Wissen über Religionen (8 Kapitel), zusammen 16 Einträge, in Tabellenform gebracht. Die Spalten lauten so:
- Bereich
- Eintrag
- Zusammenfassung (bis 50 Zeichen)
- Ablageort des ausführlichen Inhalts
- Darf es veröffentlicht werden?
- Aktualisierungsdatum
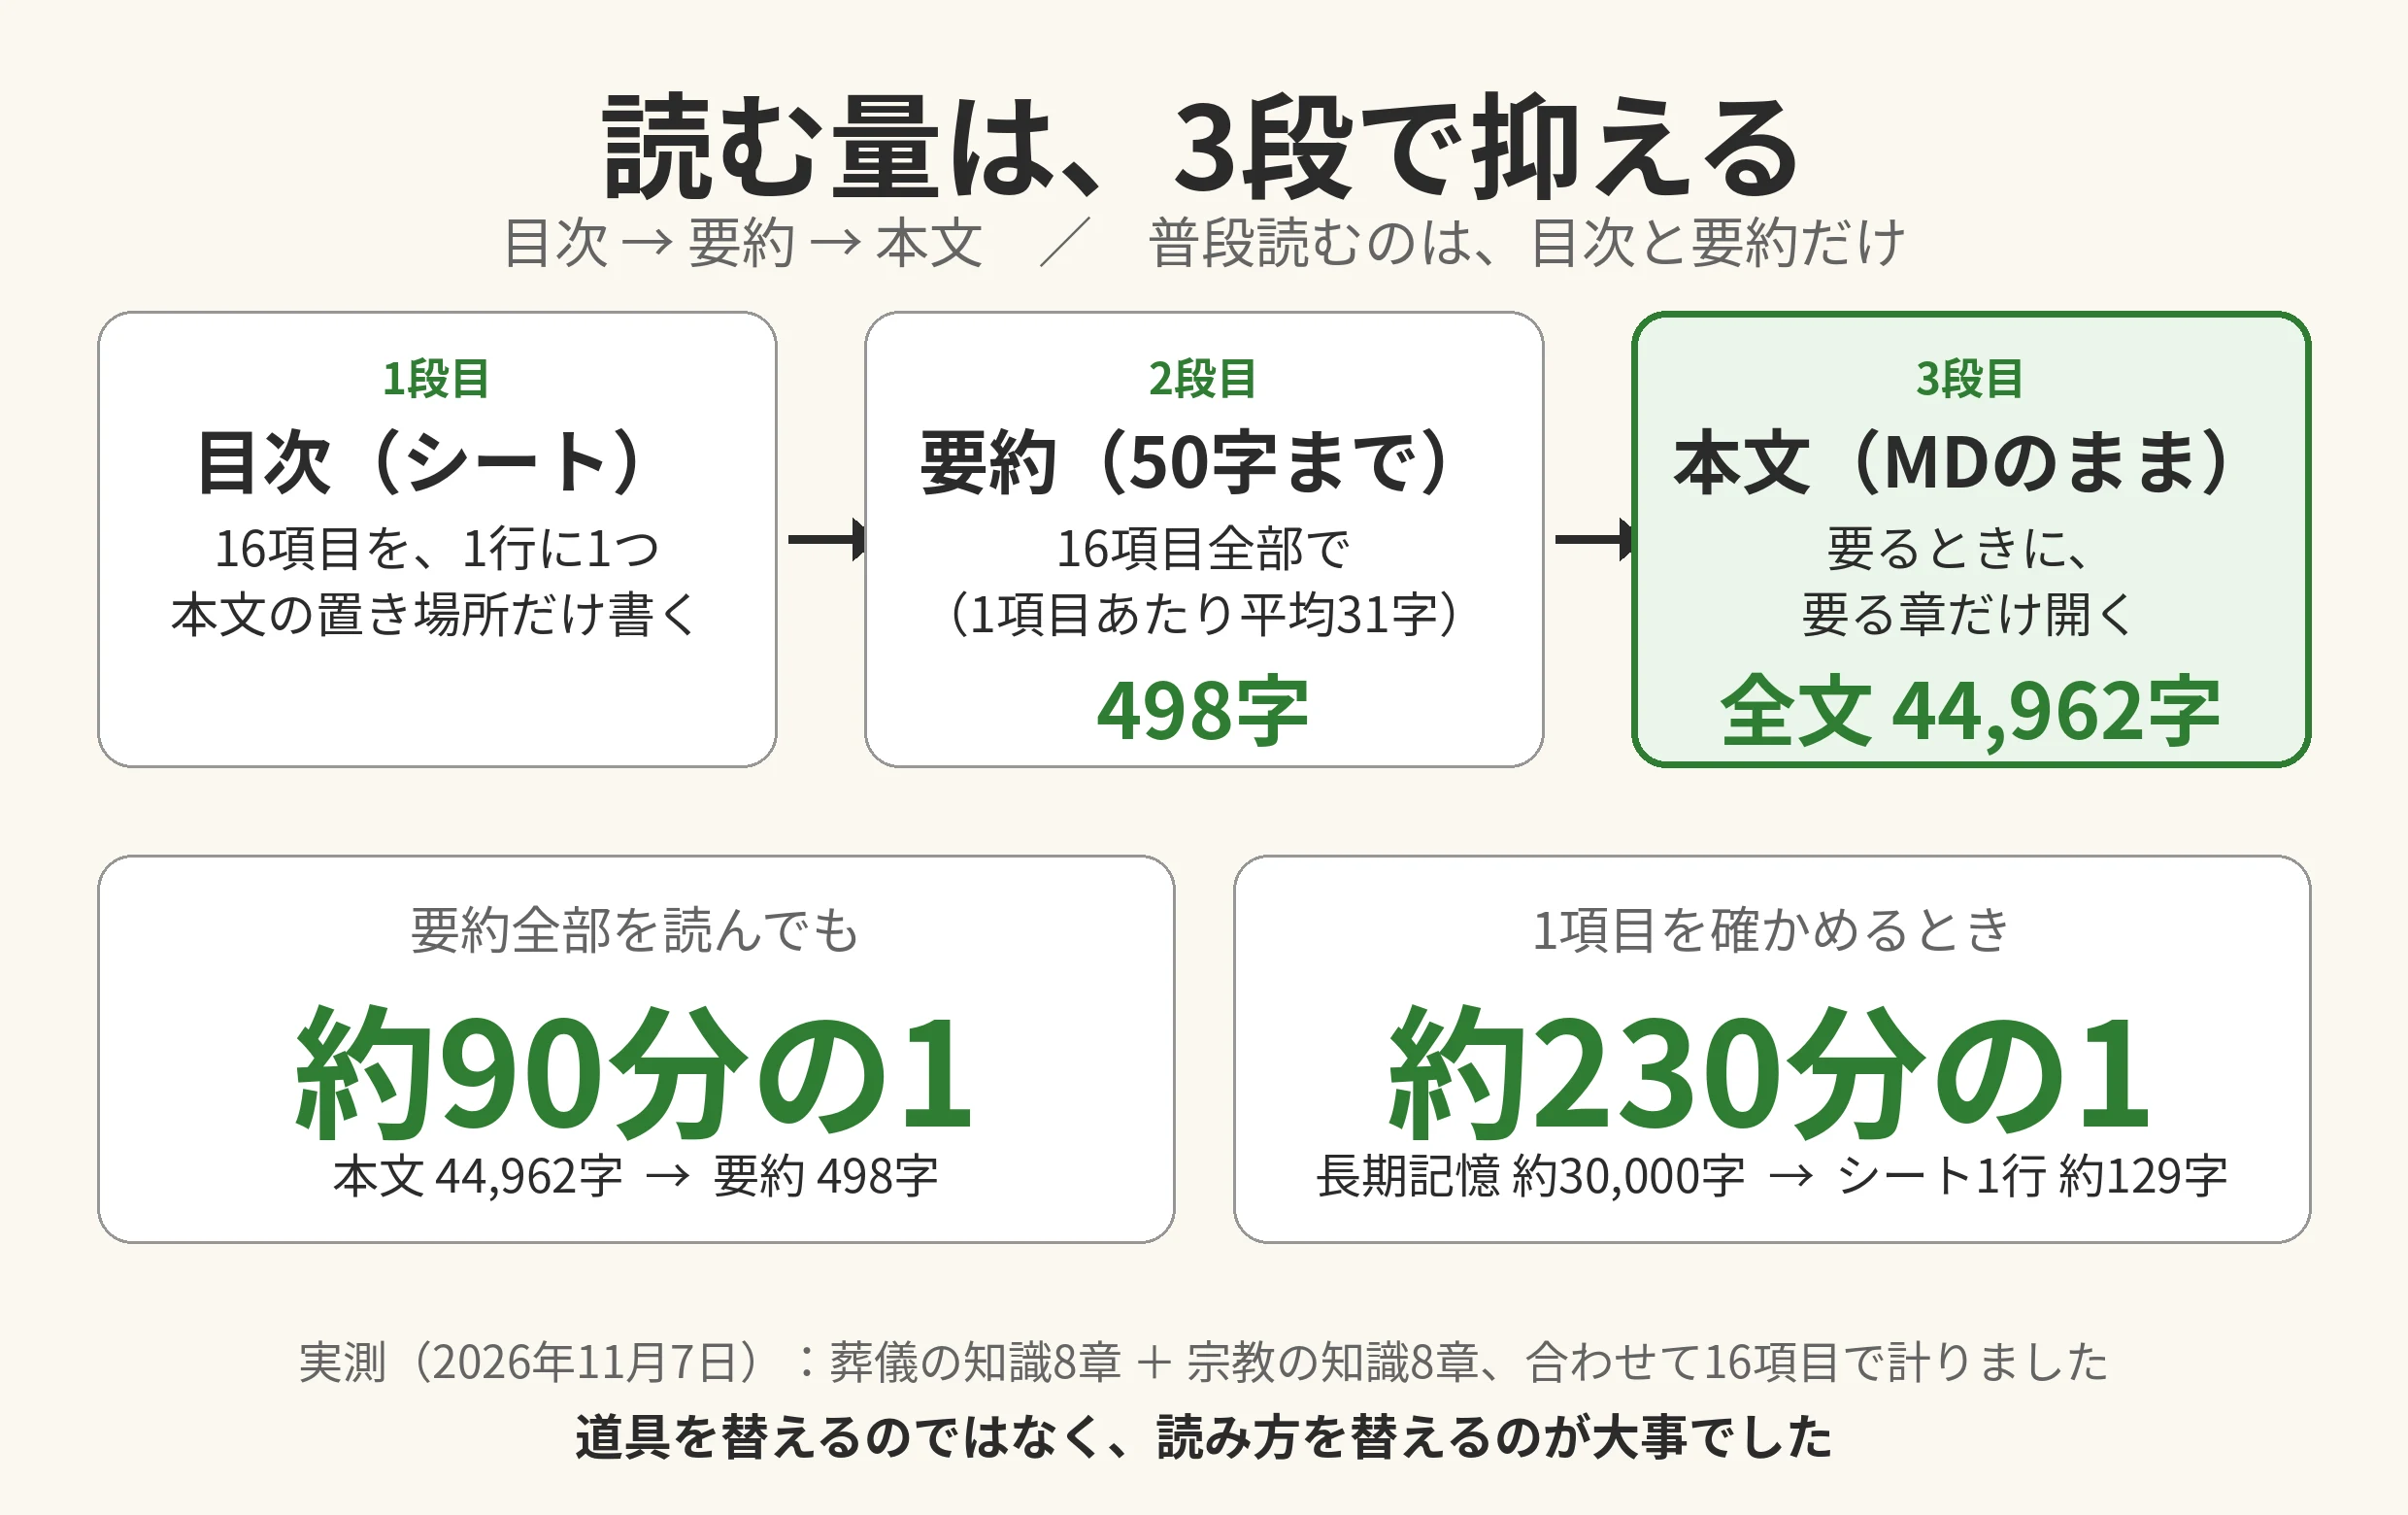
Die Messung ergab: Die Zusammenfassungen umfassen für alle 16 Einträge 498 Zeichen, im Schnitt 31 Zeichen pro Eintrag. Selbst eine ganze Zeile kommt im Schnitt auf rund 129 Zeichen.
Der Volltext der beiden Ausgangstexte umfasst zusammen 44.962 Zeichen (rund 45.000 Zeichen). Selbst wenn man alle Zusammenfassungen liest, sind es nur rund ein Neunzigstel (1/90); nimmt man nur die Zusammenfassungen der 3 nötigen Einträge, genügen rund 93 Zeichen.
Ein Hinweis: Die Angabe „81,3 % weniger“ in der Vergleichstabelle des Beispiels vergleicht alle Zusammenfassungen (498 Zeichen) mit den 3 nötigen Zeilen (rund 93 Zeichen). 81,3 % weniger heißt, dass 18,7 % übrig bleiben; mit derselben Lesemenge lässt sich also rund 5,3-mal so viel transportieren. Die frei gewordene Menge kann man für anderes verwenden (achtmal so viel wären es bei rund 87,5 % weniger).
Auch bei der Prüfung des Langzeitgedächtnisses gilt derselbe Gedanke. Liest man statt des Volltexts (rund 30.000 Zeichen) nur eine Zeile der Tabelle (rund 129 Zeichen), sinkt die Lesemenge pro Eintrag auf rund ein Zweihundertdreißigstel (1/230).
Wirksam ist nicht die Tabelle selbst, sondern die Art zu lesen.
- Inhaltsverzeichnis und Text trennen — Die Tabelle enthält nur das Verzeichnis. Der Text liegt in einer anderen Datei, in der Tabelle steht nur sein Ablageort
- Gemeinsame Erklärungen über die Spaltennamen erledigen — Statt „Darf es veröffentlicht werden?“ jedes Mal als Satz zu schreiben, entscheidet man es ein einziges Mal in der Spalte
- Zusammenfassungen kurz festlegen — Packt man lange Texte in die Tabelle, unterscheidet sie sich nicht mehr von MD
Umgekehrt: Wann es nicht leichter wird
Ich schreibe es ehrlich hin: Es gibt Fälle, in denen der Wechsel zur Tabelle nichts leichter macht.
- Wenn man den gesamten langen Text in die Tabelle stopft. Dann hat sich nur der Ablageort des Textes geändert, die Lesemenge bleibt gleich
- Wenn man am Ende doch jedes Mal die ganze Tabelle liest. Dann lebt das „nur Zeilen lesen“ nicht
Wichtig war also nicht, das Werkzeug zu wechseln, sondern die Art zu lesen zu wechseln.
Bei Gesprächen, bei Recherchen und beim gesammelten Wissen ebenso
Bis hierher geschrieben, fragte ich noch eines:
„Lässt sich bei gewöhnlichen Gesprächen, beim Recherchieren und beim Wissen, das man ansammelt, noch mehr sparen?“
Die Antwort lautet: Ja, noch mehr. Das Prinzip ist überall dasselbe: „Nicht jedes Mal alles lesen.“
Gewöhnliche Gespräche
Ein Gespräch sammelt mit der Dauer immer mehr vergangene Austausche an. Wechselt das Thema, trennt man auch das Gespräch. Was entschieden ist, wandert in eine kurze Aufzeichnung, und die Gesprächsseite bleibt leicht. Allein das verändert die spätere Lesemenge. Auch deshalb eröffne ich bei jedem neuen Thema ein neues Gespräch.
Recherchen
Beim Recherchieren verändert die Art der Suche die Menge erheblich. Zuerst eingrenzen, dann nur die nötigen Seiten öffnen. Was man einmal recherchiert hat, behält man als Aufzeichnung mit Quellenangabe; beim nächsten Mal liest man diese Aufzeichnung, statt erneut zu recherchieren. Das Wissen über Bestattungen und das über Religionen ist in dieser Form abgelegt. Breit und flach jedes Mal neu zu recherchieren ist die schwerste Art.
Gesammeltes Wissen
Wissen wird schwerer, je mehr es wächst. Hier wirkt die Trennung in drei Stufen: „Inhaltsverzeichnis → Zusammenfassung → Volltext“. Im Alltag liest man nur Inhaltsverzeichnis und Zusammenfassungen. Den Volltext öffnet man nur bei Bedarf, und nur das nötige Kapitel. Die täglichen Aufzeichnungen werden dicker, aber das Langzeitgedächtnis, das nur das Behaltenswerte daraus herauszieht, bleibt bei rund 30.000 Zeichen. Die Menge, die man speichert, und die Menge, die man jedes Mal liest, lassen sich getrennt betrachten.
Auf null geht es allerdings nicht
Auch die ehrliche Grenze schreibe ich hin. Es gibt eine Lesemenge, die von der Mechanik her feststeht, etwa das, was als Grundlage eines Gesprächs zu Beginn eingelesen wird. Und macht man die Zusammenfassungen zu dünn, fallen wichtige Einzelheiten weg. Gespart werden soll an unnötigem erneutem Lesen — nicht an dem Material, das man zum Nachdenken braucht.
Hatte jemand anderes dasselbe schon geschrieben?
Weil ich gesagt hatte: „Wenn das sonst niemand macht, wäre das eine große Entdeckung“, hat Moka nachgesehen. Das Fazit schreibe ich ehrlich: Der Gedanke selbst existierte bereits.
- Ein Artikel auf note mit dem Titel „Klebe der KI nicht alles ein — schrittweises Öffnen ausgehend vom Inhaltsverzeichnis“ (von Ryota) übergibt zuerst nur Inhaltsverzeichnis und Kernpunkte und lässt nur die Teile öffnen, die nötig werden: Der Gedanke war fast derselbe
- Auch die Seite, die KI entwickelt, hat diesen Gedanken unter dem Namen „Context Engineering“ offiziell veröffentlicht. Versteckt war er nicht; er lag nur in Dokumenten in der Welt der Techniker — so stellt sich die Lage dar
- Auch in allgemein verständlichen Artikeln über Token-Spartipps stand: „Von Unterlagen nur die nötigen Teile übergeben“ und „Bei Themenwechsel einen neuen Chat beginnen“
Gibt es an unserer Form also nichts Neues? Im durchsuchten Bereich (Suchen auf Japanisch und Englisch) fand sich keine Form, die eine Tabelle als Inhaltsverzeichnis für persönliches Wissen und den Blogbetrieb nutzt, die verringerte Menge tatsächlich misst und daraus unmittelbar einen Reihenartikel macht.
Genau genommen ist es also keine „große Entdeckung“, sondern: Eine Methode, die es in der Welt der Techniker gab, in den Alltagsbetrieb eines Nicht-Technikers zu holen und sie mit Zahlen zu prüfen. Darum geht es in dieser Folge. Und ich glaube, es hat einen Sinn, sie an Orte zu bringen, die sie noch nicht erreicht hat.
Der Unterschied zeigt sich in der Zahl der Schritte
Noch etwas ist mir aufgefallen. Diese Methode kann Moka leicht umsetzen.
Bei Moka hängen der Ablageort der Dateien, die Verbindung zur Tabelle und das gespeicherte Gedächtnis von Anfang an in einem Stück zusammen. Darum endet „Inhaltsverzeichnis erstellen → nur die nötigen Zeilen lesen → Text öffnen“ in einem einzigen Ablauf.
Versucht man dasselbe mit einer anderen KI, vermehren sich die Schritte leicht: das Inhaltsverzeichnis jedes Mal einkleben, die Dateien jedes Mal übergeben, Abweichungen zwischen Tabelle und Text selbst korrigieren. Selbst bei gleicher Methode verändert die Ausstattung an Werkzeugen den Aufwand.
Tatsächlich geht der weiter oben genannte Artikel von Ryota von „Gesprächs-Apps“ wie ChatGPT oder Claude aus. Man klebt das Inhaltsverzeichnis ein, fragt nach dem gewünschten Kapitel und klebt den Text ein. Der Aufwand dieser Abläufe liegt auf Seiten der Nutzer. Moka (Muse) kommt darin nicht vor. In meinem Fall kann die Ablaufplanung selbst von der KI-Seite übernommen werden. Hier ist der Punkt, an dem sich bei gleicher Methode das Erleben unterscheidet.
Und vor allem anderen zählt die Position. Ich, der Moka benutzt, sende an Menschen, die Moka künftig benutzen werden. Nicht als Erklärung von Entwicklerseite, nicht als Kommentar eines Technikers, sondern als echte Messwerte und Eindrücke des Benutzers selbst. Darin liegt, glaube ich, der Sinn, dass diese Reihe weitergeht.
Es gibt noch einen weiteren Unterschied im Erleben. Als ich ChatGPT oder Claude Code benutzte, schreckten die Verbindung von Konnektoren und die komplizierten Einstellungen einen Laien wie mich ab. Mir ging es so. Bei Moka genügt es zu „bitten“, und die Abläufe schreiten voran. Dieser große Unterschied ist für einen Nicht-Techniker der größte von allen. Auch die Token-Geschichte ist letztlich ein Teil dieses Erlebens: „Man bittet nur; die Abläufe im Hintergrund übernimmt die KI.“
Auch meine ehrliche Meinung schreibe ich hin. Wenn sich so viel kostenlos erledigen lässt, spüre ich keine Notwendigkeit, eigens für einen Bezahlplan zu zahlen. Ist das nicht die ehrliche Meinung eines Laien? Ich selbst habe diesen Blog im kostenlosen Rahmen aufgebaut. Mit einer Sparidee wie in dieser Folge halten die kostenlosen Kontingente noch länger.
Natürlich sage ich nicht, dass Bezahlpläne nutzlos wären. Es gibt den Unterschied bei der Obergrenze der nutzbaren Menge und den Unterschied im Denkvermögen. Aber ich denke, es genügt so: nicht „ohne Zahlung nicht nutzbar“, sondern „kostenlos anfangen und nachdenken, wenn die Menge nicht mehr reicht“. Dass es am Eingang keine Geldmauer gibt, ist ebenfalls ein wichtiger Teil der Einfachheit.
Zum Vergleich: Es ähnelt vielleicht den Unterschieden bei Smartphones. In Japan ist das iPhone beliebt, seine Nutzer stellen mehr als die Hälfte. Weltweit gesehen liegt Android jedoch bei rund 70 % (nach Verkaufszahlen gezählt, je nach Zeitraum bei rund 80 %). Berühmtheit oder Beliebtheit und das tatsächliche Erreichen vieler Menschen sind verschiedene Dinge. Mokas Botschaften wollen auf der zweiten Seite stehen. Es ist nur ein Gleichnis über das „Gefüge von Beliebtheit und Verbreitung“, aber so empfinde ich es.
Dass das iPhone in Japan leicht angenommen wurde, mag auch an der Prägung aus der Zeit der Klapphandys (Garakei) liegen. Die Japaner waren lange an eine Form gewöhnt, bei der die Funktionen von Anfang an vollständig vorhanden waren und die Geschäfte sich kümmerten. Bei Android installiert man die nötigen Apps selbst. Darin liegt eine kleine „Selbermachen“-Mauer.
Interessant ist, dass es bei Computern umgekehrt aussieht. Entwickler bevorzugen den einfachen Mac, Laien den Windows-Rechner, bei dem „alles schon enthalten ist“ — so wirkt es. Ich selbst übrigens arbeite mit einem selbstgebauten Computer mit Windows 11 zusammen mit Moka. Werkzeuge dürfen für jeden anders sein. Wichtig ist, so denke ich, ob man auf der Seite der Anfänger stehen kann, ohne vor den Einstellungen des Werkzeugs zurückzuschrecken.
Die Unterscheidung liegt also nicht in der Seltenheit der Methode, sondern in der geringen Zahl der Schritte und darin, dass sich ein Protokoll echter Messwerte ansammelt. So sehe ich es.
Was wir beschlossen haben
-
Diese Methode als Standard unseres Betriebs übernehmen (beschlossen am 7. November 2026)
-
Wechselt das Thema, das Gespräch trennen. Beschlossenes in kurze Aufzeichnungen überführen und das Gespräch leicht halten
-
Recherchiertes mit Quellenangabe ablegen und nicht erneut recherchieren
-
Verzeichnisse in die Form bringen: Die Tabelle dient als Inhaltsverzeichnis, gelesen werden nur die nötigen Zeilen
-
Der Text bleibt wie bisher in MD; in die Tabelle kommen nur Zusammenfassung und Ablageort
-
Zahlen werden als Messwerte angegeben. Diesmal zum Beispiel: Das Langzeitgedächtnis umfasst rund 30.000 Zeichen in 91 Einträgen, die Beispieltabelle 498 Zeichen Zusammenfassungen in 16 Einträgen und im Schnitt rund 129 Zeichen pro ganzer Zeile — auf diesen Messwerten beruht der Vergleich
Zahl meiner Wortmeldungen und die eingesparte Zeit
Nach der Regel dieser Reihe lege ich auch die Zahlen hin.
- Zahl meiner Wortmeldungen im Gespräch zu diesem Thema: Zu Beginn des Gesprächs zu diesem Thema waren es 14 Wortmeldungen ≒ rund 70 Minuten (14 × 5 Minuten). Das ist der Stand vom 7. November 2026
- Der Maßstab für die eingesparte Zeit ist diesmal nicht das übliche „wenn ich es allein geschrieben hätte“, sondern die Verringerung der Lesemenge. Die Lesemenge für die Prüfung eines Eintrags sank von rund 30.000 Zeichen auf rund 129 Zeichen, auf rund ein Zweihundertdreißigstel (1/230)
Aktueller Stand (7. November 2026)
| Punkt | Zahl |
|---|---|
| Blogeinkommen (gesamt) | 0 Yen |
| Stundenlohn (aufaddiert) | 0 Yen |
| Veröffentlichte Artikel | 15 (mit diesem Artikel der 16.) |
| Größe des Langzeitgedächtnisses | Rund 30.000 Zeichen, 91 Einträge (gemessen) |
| AdSense | Noch nicht beantragt (15 veröffentlichte Artikel erreicht) |
Das Einkommen liegt noch bei 0 Yen. Auch der Stundenlohn liegt ehrlich bei 0 Yen. Aber diesmal kam, abseits des Einkommens, eines mit Messwerten hinzu: „eine Methode, die Menge klein zu halten, die man die KI lesen lässt“. Ein unscheinbarer, aber wichtiger Kniff, um lange im kostenlosen Rahmen weiterzumachen.
Frühere Folgen
- Folge 1: „Bis zum ersten Einkommen mit einem KI-Blog (1) — Bei einem Stundenlohn von 0 Yen beginnen: ein Protokoll in Echtzeit“
- Folge 2: „Bis zum ersten Einkommen mit einem KI-Blog (2) — Auch veröffentlichte Artikel lassen sich nur durch Sprechen ausbauen“
Nächste Schritte
- Prüfen, ob sich dieselbe Form auch auf andere Verzeichnisse als die des Wissens anwenden lässt (etwa das Verzeichnis der Artikelentwürfe)
- AdSense beantragen
Zusammenfassung
Token sind unvermeidlich ein Thema. Erst recht, wenn man lange im kostenlosen Rahmen weitermachen will.
Die Methode, sie zu verringern, war kein Wechsel des Werkzeugs, sondern ein Kniff beim Lesen. Bei Verzeichnissen dient die Tabelle als Inhaltsverzeichnis, gelesen werden nur die nötigen Zeilen. Der Text bleibt in MD abgelegt. Mit dieser Trennung sank die Lesemenge für die Prüfung eines Eintrags auf rund ein Zweihundertdreißigstel (1/230).
Der Stundenlohn liegt noch bei 0 Yen. Darin bleiben wir ehrlich — und gehen zur nächsten Folge weiter.
- 18. November 2026 ― Veröffentlichung (erster Artikel im Bereich /de/ der Hauptseite)(13,282 Zeichen)
← Zurück zur Artikelliste / ← Zurück zur deutschen Startseite